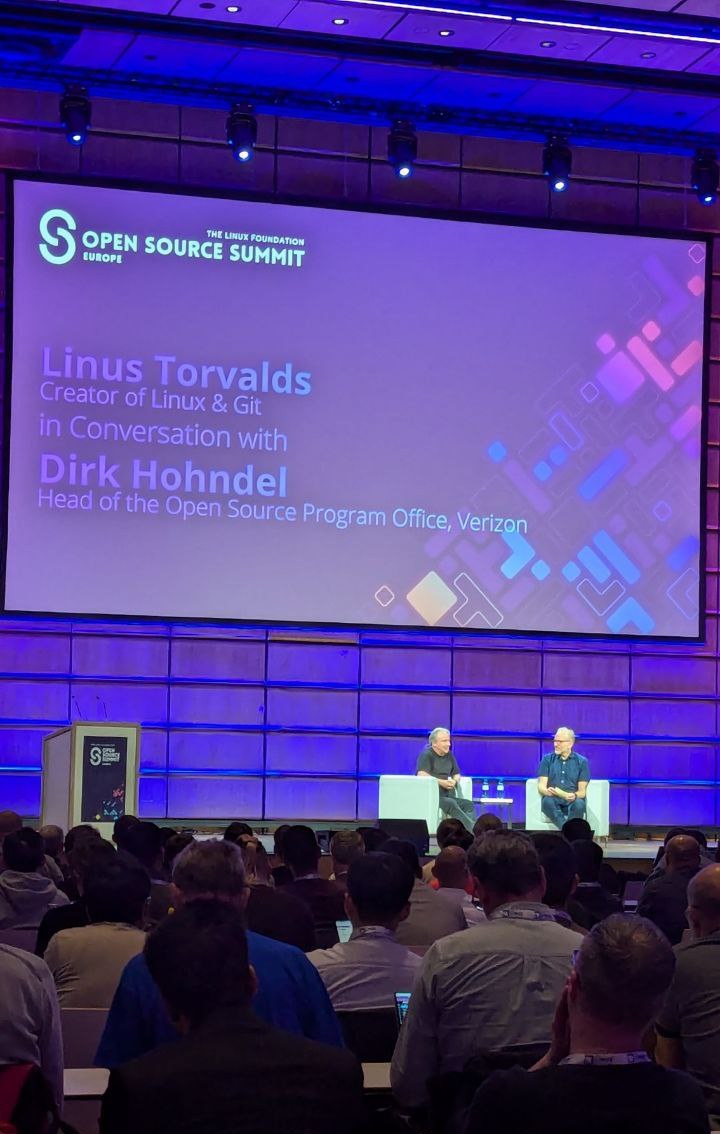
Piątek, 9 października, Praga. W Kongresowym Centrum na Pankracu, wielkim betonowym gmachu nad doliną Nusli, kończy się Open Source Summit Europe, konferencja Linux Foundation, która w tym roku świętuje 35 lat Linuksa. Na scenie dwa fotele. W jednym Linus Torvalds, w drugim jego wieloletni kolega Dirk Hohndel, który od lat prowadzi z nim te same publiczne rozmowy. Temat jest przewidywalny, bo w 2026 roku na konferencjach programistycznych nie ma innego: sztuczna inteligencja.
Przewidywalne nie są odpowiedzi. Torvalds mówi rzeczy, które jeszcze dwa lata temu nie przeszłyby mu przez gardło. Według relacji ZDNet: „I actually really like using AI”. Że AI to wspaniałe narzędzie, jeśli używa się jej poprawnie i traktuje jak narzędzie. Że programowanie staje się dzięki niej przyjemniejsze. Że używa jej do rzeczy, w których jest słaby. I, ostrożnie, że sam niewiele już programuje w jądrze: „I don't do a lot of kernel programming. I'm a maintainer”.
To ostatnie zdanie zestarzało się w kilkanaście godzin.
Sobota, 7:05 rano
W publicznym repozytorium Linuksa, które Torvalds prowadzi na serwerach kernel.org, leżała już wtedy niemal gotowa gałąź o nazwie niezostawiającej wątpliwości: noref-filemap-read-with-llm. Pierwsze commity powstały 7 października, zanim jeszcze konferencja się zaczęła. Ostatni, z długim opisem całej serii, nosi znacznik czasu 10 października, 7:05:38, strefa +0200. Czas środkowoeuropejski letni. Rano po rozmowie na scenie, jeszcze w Pradze, twórca Linuksa zamknął osiem łatek do podsystemu zarządzania pamięcią, czyli do samego środka jądra.
W sekcji „Tools” opisu napisał wprost, że kod, programy testowe, przegląd stojący za listą znanych problemów i pierwsza wersja samego opisu powstały z asystentem programowania (Claude Code) pod jego kierunkiem. Pomiary zrobił sam, na swoim komputerze.
Gałąź wypatrzył w niedzielę 11 października Michael Larabel z Phoronixa, odświeżając repozytorium w oczekiwaniu na Linuksa 7.3-rc7. Od tego momentu historia obiegła cały branżowy internet, od It's FOSS po Slashdota. Sprawdziłem u źródła: gałąź jest w repozytorium Torvaldsa, a każdy z ośmiu commitów nosi jego podpis.
Co właściwie zrobił
Problem jest stary i bardzo konkretny. Gdy wiele wątków czyta małe kawałki tego samego pliku, który siedzi już w pamięci podręcznej (page cache), jądro przy każdym odczycie bierze referencję do strony pamięci i zaraz ją oddaje. Każda taka operacja to atomowy zapis do tego samego miejsca w pamięci, więc rdzenie procesora zaczynają się o nie bić. Torvalds pisze, że na jego laptopie, przy ośmiu wątkach czytających po 16 bajtów, ta jedna linia pamięci odpowiada za 99,92 proc. konfliktów. Zwrócił na to uwagę Matthew Wilcox już w 2024 roku, na podstawie obciążenia u jednego z klientów.
Pomysł z łatek da się streścić jednym zdaniem: strona usunięta z page cache wraca do alokatora dopiero po upływie okresu łaski mechanizmu RCU. Skoro pamięć na pewno nie zostanie w międzyczasie użyta do czegoś innego, czytelnik może skopiować dane prosto do bufora użytkownika bez brania referencji, bez bufora pośredniego i bez sprawdzania po fakcie.
Wcześniejsze próby, w tym seria „fast short reads” Kiryła Szutiemowa, kopiowały dane bez referencji, a potem weryfikowały wynik. Utknęły na przypadkach, których weryfikacja nie widzi: zwolnieniu i ponownym użyciu strony, migracji pamięci, czytaniu z obszarów, które przestały być page cache. Torvalds zamiast wykrywać te przypadki, usuwa je u źródła. Sam przyznaje, że pomysł był podsuwany kilka razy i nikt go nie spróbował. Wilcox miał wtedy zastrzeżenie, które Torvalds cytuje uczciwie: trzymanie tak dużej ilości pamięci w poczekalni „wydaje się po prostu zbyt ryzykowne”. I dodaje, że to właśnie ta część serii jest najmniej rozwiązana.
Wyniki z jego laptopa (Intel Core i7-8565U, 4 rdzenie, 8 wątków, ext4, wyłączone łatki na luki procesorów, czyli mitigations off, i wyłączone CONFIG_HARDENED_USERCOPY) wyglądają tak:
Z jednym wątkiem zysk jest skromny, z około 8 do 8,8-8,9 mln odczytów na sekundę. Przy czterech wątkach, po jednym na rdzeń, z 8,9-11,6 do 25-26 mln. Sam autor zastrzega, że laptop dławi się temperaturą, więc rzetelniej porównywać koszt jednego odczytu niż odczyty na sekundę. Że maszyna z większą liczbą procesorów powinna zyskać więcej. I że nic większego niż ten laptop nie było mierzone.
Najważniejsza jest lista wad
Kto zna Torvaldsa z dawnych, słynnie ostrych maili, spodziewałby się tryumfu. Tymczasem najdłuższa część opisu nosi tytuł „Known problems, and what I'd like eyes on”, czyli znane problemy i prośba o czyjeś oczy. Punktów jest dziesięć. Kilka z nich warto wymienić, bo pokazują, jak wygląda uczciwa praca z agentem:
- Alokator nie widzi stron czekających na zwolnienie. W testowej maszynie wirtualnej Kiryła Szutiemowa (2 GiB pamięci, bez swapu) sama pierwsza szóstka łatek, bez 7 i 8, doprowadziła do wywołania OOM killera, choć setki megabajtów czekały w kolejce. Łatki 7 i 8 skracają kolejki, ale problemu nie rozwiązują, a limit 1024 stron Torvalds sam nazywa zgadywanką.
- Seria w obecnym kształcie psuje alokację ciągłych obszarów pamięci (CMA). Torvalds otwarcie nazywa to regresją.
- Nie przeszła xfstests, nie była testowana z lockdep ani KASAN, na 32 bitach, z jądrem zlinkowanym clangiem ani na żadnej maszynie poza jego laptopem.
- Koszt poza ścieżką odczytu nie został zmierzony. Przy obciążeniach, które dużo zwalniają i obcinają pliki, „potrzebne są liczby”.
- W punkcie o planiście zadań (schedulerze) pisze wprost, że nie jest pewien, czy to dobry kierunek.
To jest ciekawsze niż same liczby. Agent napisał kod i testy, ale też przegląd własnych słabości, a człowiek podpisał to wszystko nazwiskiem i wystawił do publicznej krytyki. W sekcji o testach jest zdanie, które powinno wisieć nad biurkiem każdego, kto pracuje z modelami językowymi: to, co wymienione, to wszystkie testy, jakie są. Nic więcej nie zrobiono i nic więcej nie jest obiecywane.
Niedziela, poniedziałek, wtorek
Gdyby to był jednorazowy eksperyment, można by go zbyć. Ale w niedzielę 11 października, o 12:54 z podpisem strefy -0700, czyli już z czasem Pacyfiku, w repozytorium pojawił się podpisany kluczem PGP tag assoc-array-fixes. Torvalds opisał w nim, że Nils Ollrogge zgłosił błąd w bibliotece assoc_array razem z poprawką, tylko że kod był dla niego zbyt zawiły, więc - jak napisał - „I did what I preach”: użył nowoczesnych narzędzi LLM, żeby to wszystko zrozumieć. Gałąź rozbija duże, nieczytelne funkcje na mniejsze, a uruchomiona w przestrzeni użytkownika uprząż testowa potwierdziła zgłoszony błąd i znalazła trzy kolejne. Wszystkie siedziały w kodzie od pierwszego commita tej biblioteki z 2013 roku.
Trzynaście lat. Tyle czasu trzy błędy przeżyły w jądrze systemu, na którym stoi większość serwerów internetu i każdy telefon z Androidem, bo nikt nie miał cierpliwości przekopać się przez funkcje pełne skoków goto. Tego samego wieczoru Torvalds wydał Linuksa 7.3-rc7, jakby nic się nie stało.
Potem do gry wszedł człowiek, który od początku był w tej historii. W poniedziałek 12 października Kirył Szutiemow, dziś w Meta, ten sam, którego maszyna wirtualna zabijała procesy, przygotował dwie własne łatki. Jedna liczy strony czekające na okres łaski i zwalnia je, zanim jądro sięgnie po OOM killera. W opisie podaje wynik testu: w maszynie z 2 GB pamięci i 64 wirtualnymi procesorami, bez dodatkowego mechanizmu przyspieszania, proces obok czytelników był zabijany w 5 z 8 przebiegów. Obie łatki mają tag Assisted-by: LLM.
We wtorek 13 października rano Torvalds wystawił w repozytorium nową gałąź rcu-free-v3. Dziesięć commitów: osiem jego, w nowym układzie, i dwa Szutiemowa na końcu. Punkt pierwszy z listy wad, ten o alokatorze, który nie widzi czekających stron, dostał pierwszą odpowiedź w niecałe cztery dni. Od człowieka, z pomocą maszyny, w odpowiedzi na publicznie wypisaną słabość. Tak w praktyce wygląda proces, o który chodzi.
Od „90 procent marketingu” do „naprawdę lubię”
Żeby zrozumieć wagę tego tygodnia, trzeba pamiętać, skąd Torvalds wyszedł. Jesienią 2024 roku, w Wiedniu, na poprzednim takim szczycie i w wywiadzie dla TFiR, mówił, że AI jest ciekawa i zmieni świat, ale nienawidzi cyklu hype'u, więc na razie ją ignoruje, bo branża AI to w jego ocenie „90% marketing and 10% reality”. Dawał sobie pięć lat na rewizję tej oceny. Wystarczyły dwa.
Zmiana szła etapami i warto je wypunktować:
- Styczeń 2026. W sporze o wytyczne dla kodu generowanego narzędziami Lorenzo Stoakes z Oracle chciał zapisów pozwalających odrzucać podejrzany „AI slop”. Torvalds odpisał na liście, że nie ma sensu rozmawiać o AI slop, bo autorzy śmieciowych łatek i tak ich nie oznaczą, a dokumentacja jest dla uczciwych. Chciał, by AI była opisana jako „just a tool”, bez straszenia i bez zachwytów.
- Styczeń 2026. Opublikował hobbystyczny projekt AudioNoise o efektach gitarowych. Kod w C pisał sam, ale wizualizator w Pythonie, jak przyznał w README, zrobił vibe codingiem w Google Antigravity.
- Maj 2026. Przy Linuksie 7.1-rc4 napisał, że ciągły zalew raportów z narzędzi AI uczynił listę bezpieczeństwa jądra „almost entirely unmanageable”, z ogromną liczbą duplikatów. Zarazem dodał, że narzędzia AI są świetne, ale tylko wtedy, gdy naprawdę pomagają.
- Sierpień 2026. Przy 7.2-rc7 przyznał, że nie jest zachwycony rozmiarem wydania, ale to „nowa normalność” z masą poprawek, wiele z nich z przeglądów robionych przez narzędzia AI.
- Październik 2026. Praga, scena, „I actually really like using AI”. I osiem łatek z Claude Code.
AI to wspaniałe narzędzie, jeśli używasz go poprawnie i traktujesz jak narzędzie - mówił w Pradze Torvalds, dodając, że przy rzeczach naprawdę ważnych trzeba być bardzo ostrożnym.
W tej samej rozmowie opowiedział też, że gdy dał AI zwykły prompt do interfejsu swojego pedału gitarowego, wynik był „horrendous”. Dopiero gdy pokazał jej swój własny, poprawny, choć brzydki kod w C, zaczęło to działać. Bronił też vibe codingu: z niego się śmieją, a według niego to wspaniały sposób, żeby znaleźć radość w programowaniu. Rozróżnienie jest jasne - zabawa w domu to jedno, kod, na którym działa świat, to drugie. Nie ufa narzędziu, które zgaduje. Ufa narzędziu, które pracuje pod nadzorem kogoś, kto wie, czego chce.
Jakie reguły ma jądro
Linux nie wpuszcza kodu z AI bez zasad, ale też go nie zakazuje. W 2026 roku w dokumentacji jądra pojawiły się dwa dokumenty. Pierwszy, coding-assistants.rst, dodany po ustaleniach Maintainers Summit z 2025 roku, mówi trzy rzeczy:
- agent nie może dodawać tagu Signed-off-by, bo certyfikat pochodzenia kodu (DCO) poświadczyć może tylko człowiek;
- człowiek odpowiada za przejrzenie całego kodu;
- wkład AI oznacza się tagiem Assisted-by.
Drugi, generated-content.rst, przygotowany przez radę techniczną fundacji, prosi o przejrzystość: jakich narzędzi użyto, z jakimi promptami, jak to przetestowano. I zostawia maintainerom wolną rękę, łącznie z odrzuceniem łatki bez szczegółowego przeglądu, jeśli autor nie potrafi jej obronić.
Ciekawy szczegół: w cyklu 7.3 Christian Brauner przeforsował uproszczenie tagu. Wymóg podawania konkretnego modelu, jak argumentował, robił darmową reklamę firmom z zamkniętym oprogramowaniem, a niewiele mówił. Od tego czasu wystarczy Assisted-by: LLM. Każda z ośmiu łatek Torvaldsa ma dokładnie ten tag i jego Signed-off-by. Nazwę Claude Code podał tylko w opisie serii, dobrowolnie.
Torvaldsowa seria to wzorcowy przykład, jak te procedury mają wyglądać w praktyce. W sierpniu do coding-assistants.rst trafiła instrukcja, jak agent ma szukać i poprawiać błędy: z reproduktorem, testem i uczciwym wypisaniem, czego nie udało się sprawdzić. Pod koniec września Sasha Levin z NVIDII zaproponował dodanie do jądra pliku AGENTS.md dla agentów AI, a na początku października katalogu z „umiejętnościami” dla asystentów programowania, na start z jedną, która ma ustalać tag Fixes w nowych łatkach. Jądro nie tylko toleruje agentów. Zaczyna pisać dla nich instrukcje obsługi.
Druga strona medalu: curl
Żeby nie było zbyt sielankowo. Ta sama technologia, która pozwala Torvaldsowi w trzy dni rozgrzebać problem leżący od 2024 roku, zalewa innych opiekunów projektów śmieciami.
Najgłośniejszy przypadek to curl, maleńkie narzędzie do przesyłania danych, które siedzi w miliardach urządzeń, a utrzymuje je garstka ludzi wokół Szweda Daniela Stenberga. Program nagród za znalezione błędy działał od 2019 roku. Według samego Stenberga przez ten czas potwierdzono w nim 87 podatności i wypłacono ponad 100 tys. dolarów. Ale w 2025 roku odsetek zgłoszeń opisujących prawdziwy problem spadł poniżej 5 proc., z wcześniejszych kilkunastu. Nie było nawet jednego prawdziwego na dwadzieścia.
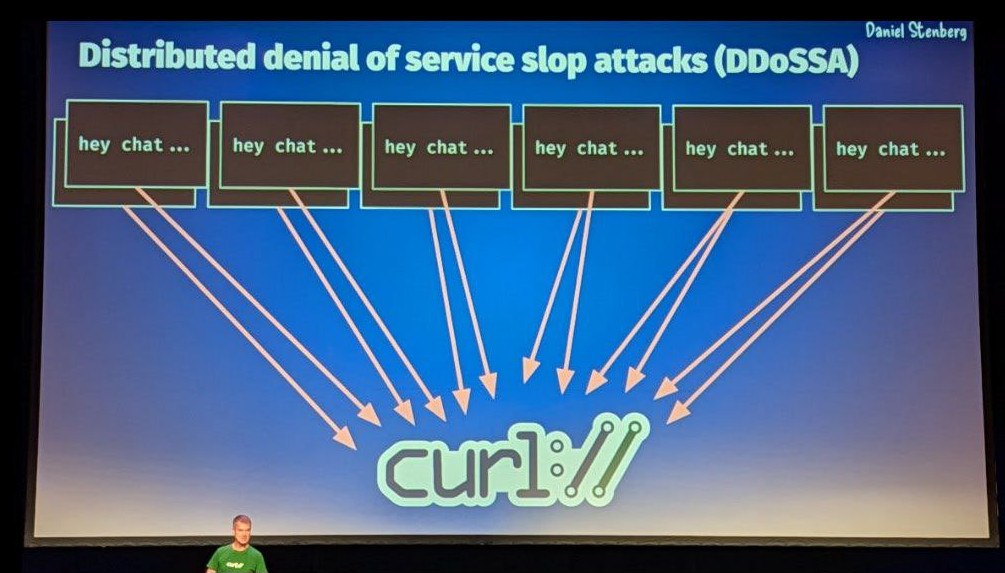
Latem 2025 roku na tej samej konferencji, na której w tym roku siedział Torvalds, Stenberg pokazywał slajd o „rozproszonych atakach odmowy usługi przez slop” - grę słów na DDoS. Kilka miesięcy później skapitulował. Program zgłoszeń z nagrodami przyjmował raporty do 31 stycznia 2026 roku, od 1 lutego curl zbiera je bez pieniędzy, przez prywatne zgłaszanie podatności na GitHubie i e-mail zespołu bezpieczeństwa. W pożegnalnym wpisie z 26 stycznia Stenberg wymienił trzy powody: ogłupiający zalew AI slop, ludzi wypadających gorzej niż kiedykolwiek i wyraźną chęć dziurawienia zamiast pomagania. Tłumaczył też, że chodzi o usunięcie zachęty do wysyłania byle jakich, niezbadanych zgłoszeń, czy to z AI, czy nie.
To ta sama choroba, na którą Torvalds narzekał w maju. AI świetnie znajduje podejrzane miejsca, a ludzie kopiują jej wyniki bez zrozumienia i wysyłają w nadziei na nagrodę. Różnica między Pragą a curlem nie leży w narzędziu. Leży w tym, kto podpisuje wynik i czy w ogóle go przeczytał.
Mapa podziałów
Projekty open source nie mają w tej sprawie jednego zdania. Mapa wygląda mniej więcej tak:
| Projekt | Podejście do kodu z AI |
|---|---|
| Linux | Dozwolony, z tagiem Assisted-by i pełną odpowiedzialnością człowieka |
| Fedora | Dozwolony od października 2025, odpowiedzialność po stronie autora |
| Debian | Uchwała z sierpnia 2026: ani zachęta, ani zakaz; ujawnienie mile widziane, ale nieobowiązkowe |
| QEMU | Odrzuca wkład zawierający treści wygenerowane przez AI lub z nich pochodzący; AI wolno używać do analizy i debugowania |
| Gentoo | Zakaz od kwietnia 2024 (prawa autorskie, jakość, etyka) |
| NetBSD | Od maja 2024 kod z LLM uznawany za „skażony”, wymaga zgody zarządu projektu |
Najciekawszą drogę przeszedł Debian, jedna z najstarszych i najważniejszych dystrybucji, z której wywodzi się m.in. Ubuntu. W 2024 roku, gdy Gentoo i NetBSD wprowadzały zakazy, Debian się nie przyłączył. Na początku 2026 roku nie udało się nawet uzgodnić projektu uchwały. Latem doszło do głosowania ogólnego, w którym na karcie były różne warianty, od twardego zakazu po zgodę z warunkami. Między 15 a 28 sierpnia deweloperzy wybrali propozycję Marca Habera „Responsible Use of Generative AI”.
Uchwała mówi, że Debian „ani nie popiera, ani nie zakazuje” generatywnej AI, ale od wkładu wymaga tych samych standardów jakości, poprawności i zgodności z prawem. Autor ma rozumieć, przejrzeć, przetestować i w razie potrzeby poprawić to, co wyszło z modelu. Ujawnienie użycia AI jest zalecane, nie wymagane. Do zewnętrznych usług AI nie wolno wrzucać informacji poufnych, w tym nieujawnionych luk bezpieczeństwa. A opiekunowie pakietów nadal mogą odmówić przyjęcia takiego wkładu.
Po drugiej stronie stoi QEMU, emulator, na którym opiera się spora część wirtualizacji. Jego argument jest prawniczy, nie technologiczny: status praw autorskich do tego, co produkuje model, jest „niejasny”, a dane treningowe zawierają kod na licencjach, których QEMU nie może przyjąć. Skoro tak, autor nie może uczciwie złożyć tego samego certyfikatu pochodzenia (DCO), na którym Linux opiera swoje zasady. Projekt zastrzega, że reguła może się zmienić, gdy narzędzia dojrzeją, a sytuacja prawna się wyjaśni.
Ciekawe, że Linux i QEMU powołują się na ten sam dokument, a dochodzą do przeciwnych wniosków. Jądro mówi: DCO podpisuje człowiek, więc człowiek bierze ryzyko. QEMU mówi: człowiek nie wie, co podpisuje, więc niech nie podpisuje.
Agent jako współpracownik, nie autor
Ten tydzień zamyka pewien etap sporu. Przez dwa lata dyskusja o AI w open source krążyła wokół pytania „czy wolno?”. Gentoo i NetBSD odpowiedziały, że nie. curl odpowiedział, że nie za pieniądze. Debian, że tak, ale na twoją odpowiedzialność. Torvalds odpowiedział inaczej: pokazując, jak.
Jego seria jest wzorcowym przykładem. Agent dostał trudne zadanie, które ludzie rozgrzebywali od 2024 roku. Napisał kod, testy i krytykę własnej pracy. Człowiek zmierzył, sprawdził, podpisał i poprosił innych o przegląd. Inny człowiek, z pomocą tego samego typu narzędzia, odpowiedział łatkami na najpoważniejszą wadę. Nikt tu nie udaje, że maszyna jest autorem. Nikt też nie udaje, że jej nie było.
Stan na dziś: ani noref-filemap-read-with-llm, ani rcu-free-v3 nie trafiły do głównej linii jądra i nie wiadomo, czy wejdą w okno zmian Linuksa 7.4. Regresja w CMA pozostaje na liście. Może się okazać, że cały pomysł z odroczonym zwalnianiem stron jest dla jądra zbyt ryzykowny, dokładnie tak, jak w 2024 roku przeczuwał Wilcox.
Co z tego wynika dla kogoś, kto nie pisze kodu
Można zapytać: co mnie obchodzi page cache? Pośrednio sporo. Linux działa na większości serwerów, przez które przechodzi to, co robimy w internecie, w każdym telefonie z Androidem, w routerach, telewizorach i samochodach. curl siedzi w miliardach urządzeń. Debian jest pod spodem setek innych systemów. Każda decyzja tych kilku społeczności o tym, czy i jak wpuszczać kod z AI, przekłada się na oprogramowanie, z którego korzystamy, nie wiedząc o tym.
Lekcja z tego tygodnia jest jednak szersza niż informatyka. Torvalds przez trzy dekady był wzorem programisty, który nie wierzy w obietnice. Wyśmiewał mody, deklaracje i marketing, a cenił wyłącznie działający kod. Dlatego jego nawrócenie znaczy więcej niż entuzjazm kogokolwiek z Doliny Krzemowej. Gdy krytyk hype'u zaczyna używać narzędzia, znaczy to, że przestało ono być hype'em, a stało się zwykłym narzędziem.
Zwykłe narzędzie ma jednak zwykłe zasady. Ten, kto go używa, odpowiada za efekt. W pracy, w szkole, w urzędzie, coraz częściej ktoś podpisze się pod tekstem, raportem albo analizą, które napisał z AI. Praski przypadek pokazuje, jak to zrobić przyzwoicie: powiedzieć, czego się użyło, pokazać liczby z zastrzeżeniami, wypisać, czego się nie sprawdziło, i poprosić o drugą parę oczu. A przypadek curla pokazuje, co się dzieje, gdy ktoś wkleja wynik z czatu i liczy, że nikt nie zauważy.
Największą wartością łatek z Pragi nie jest trzykrotne przyspieszenie na jednym laptopie. Jest nią forma: jawność, dziesięć punktów słabości i podpis człowieka, który bierze za to odpowiedzialność. Jeśli tak ma wyglądać praca z agentami w 2026 roku, to najbardziej nieufny programista świata właśnie pokazał, jak to robić. Także tym, którzy wciąż wysyłają do niego raporty skopiowane z czatu.
Tekst ukazał się w numerze 1 tygodnika Dygot (13 października 2026).
Źródła (30)
- mm: read from the page cache without folio references - commit 4c0f369 w repozytorium torvalds/linux.git, 10.10.2026
- Gałąź noref-filemap-read-with-llm - git.kernel.org, 07-10.10.2026
- Tag assoc-array-fixes - git.kernel.org, 11.10.2026
- Gałąź rcu-free-v3 - git.kernel.org, 13.10.2026
- mm: count the pages waiting for a grace period and free them before OOM - Kiryl Shutsemau, git.kernel.org, 12.10.2026
- Linus Torvalds Working On A Hefty Linux Kernel Improvement With Claude Code - Phoronix, 11.10.2026
- Linus Torvalds „Did What I Preach”, Used AI To Make Code Decipherable & Uncovered More Bugs - Phoronix, 12.10.2026
- Linus Torvalds Experiments with AI-Generated Kernel Code, Sees 3x Speedup - Linuxiac, 10.2026
- Linus Torvalds Says He Likes Using AI, While His New Kernel Branch Credits Claude Code - It's FOSS, 12.10.2026
- 'I use AI to do the things that I'm bad at': Linus Torvalds on why it works for him - ZDNet (przedruk ThreatsHub), 09.10.2026
- Linus Torvalds On Why AI Works For Him - Slashdot, 13.10.2026
- Open Source Summit + Embedded Linux Conference Europe 2026 Schedule - PR Newswire, 2026
- Meet the Zephyr Community at Open Source Summit Europe 2026 - Zephyr Project, 2026
- Linus Torvalds reckons AI is '90% marketing and 10% reality' - Tom's Hardware, 28.10.2024
- Linus: Stop making issue of AI slop in kernel docs - The Register, 08.01.2026
- Linus Torvalds' Latest Open-Source Project Is AudioNoise - Phoronix, 01.2026
- Linus Torvalds says AI-powered bug hunters have made Linux security mailing list 'almost entirely unmanageable' - The Register, 18.05.2026
- AI Reviews Bring 'New Normal' to Linux Release Candidates - Slashdot, 10.08.2026
- AI Coding Assistants - dokumentacja jądra Linux (coding-assistants.rst), stan na 13.10.2026
- Kernel Guidelines for Tool-Generated Content - dokumentacja jądra Linux (generated-content.rst), stan na 13.10.2026
- New AI Agent Resources Proposed For The Linux Kernel - Phoronix, 08.10.2026
- The end of the curl bug-bounty - Daniel Stenberg, daniel.haxx.se, 26.01.2026
- Curl shutters bug bounty program to stop AI slop - The Register, 21.01.2026
- Curl ending bug bounty program after flood of AI slop reports - BleepingComputer, 01.2026
- General Resolution: LLM usage in Debian - debian.org, 08.2026
- Debian Opens Vote on the Future of AI-Assisted Contributions - Linuxiac, 08.2026
- Code provenance - dokumentacja QEMU, stan na 13.10.2026
- Gentoo and NetBSD ban 'AI' code, but Debian doesn't - The Register, 18.05.2024
- Fedora Approves AI-Assisted Contributions - Slashdot, 23.10.2025
- To Ban or not to Ban? How Open Source Projects Govern GenAI Contributions - arXiv, 03.2026