W poniedziałek 12 października na oficjalnym blogu Microsoftu pojawił się wpis Scotta Guthriego, wiceprezesa odpowiedzialnego za chmurę i AI. Zero gali, zero ekranu z odliczaniem - tylko suche parametry trzeciej generacji firmowego chipa Maia. Ale między wierszami tego technicznego tekstu siedzi zdanie, które dla branży znaczy więcej niż każda liczba: Maia ma się stać „podstawowym systemem inferencji" dla produktów i usług Microsoftu. Czyli tym, co odpowiada, kiedy piszesz do Copilota.
Jeszcze kilka lat temu własny chip AI był w wielkich firmach technologicznych projektem pobocznym, czymś między eksperymentem a kartą przetargową w negocjacjach z Nvidią. Dziś Google, Amazon, Meta i Microsoft mają własne linie układów, a tydzień, w którym zamyka się ten numer, pokazuje, jak bardzo to przestało być hobby.
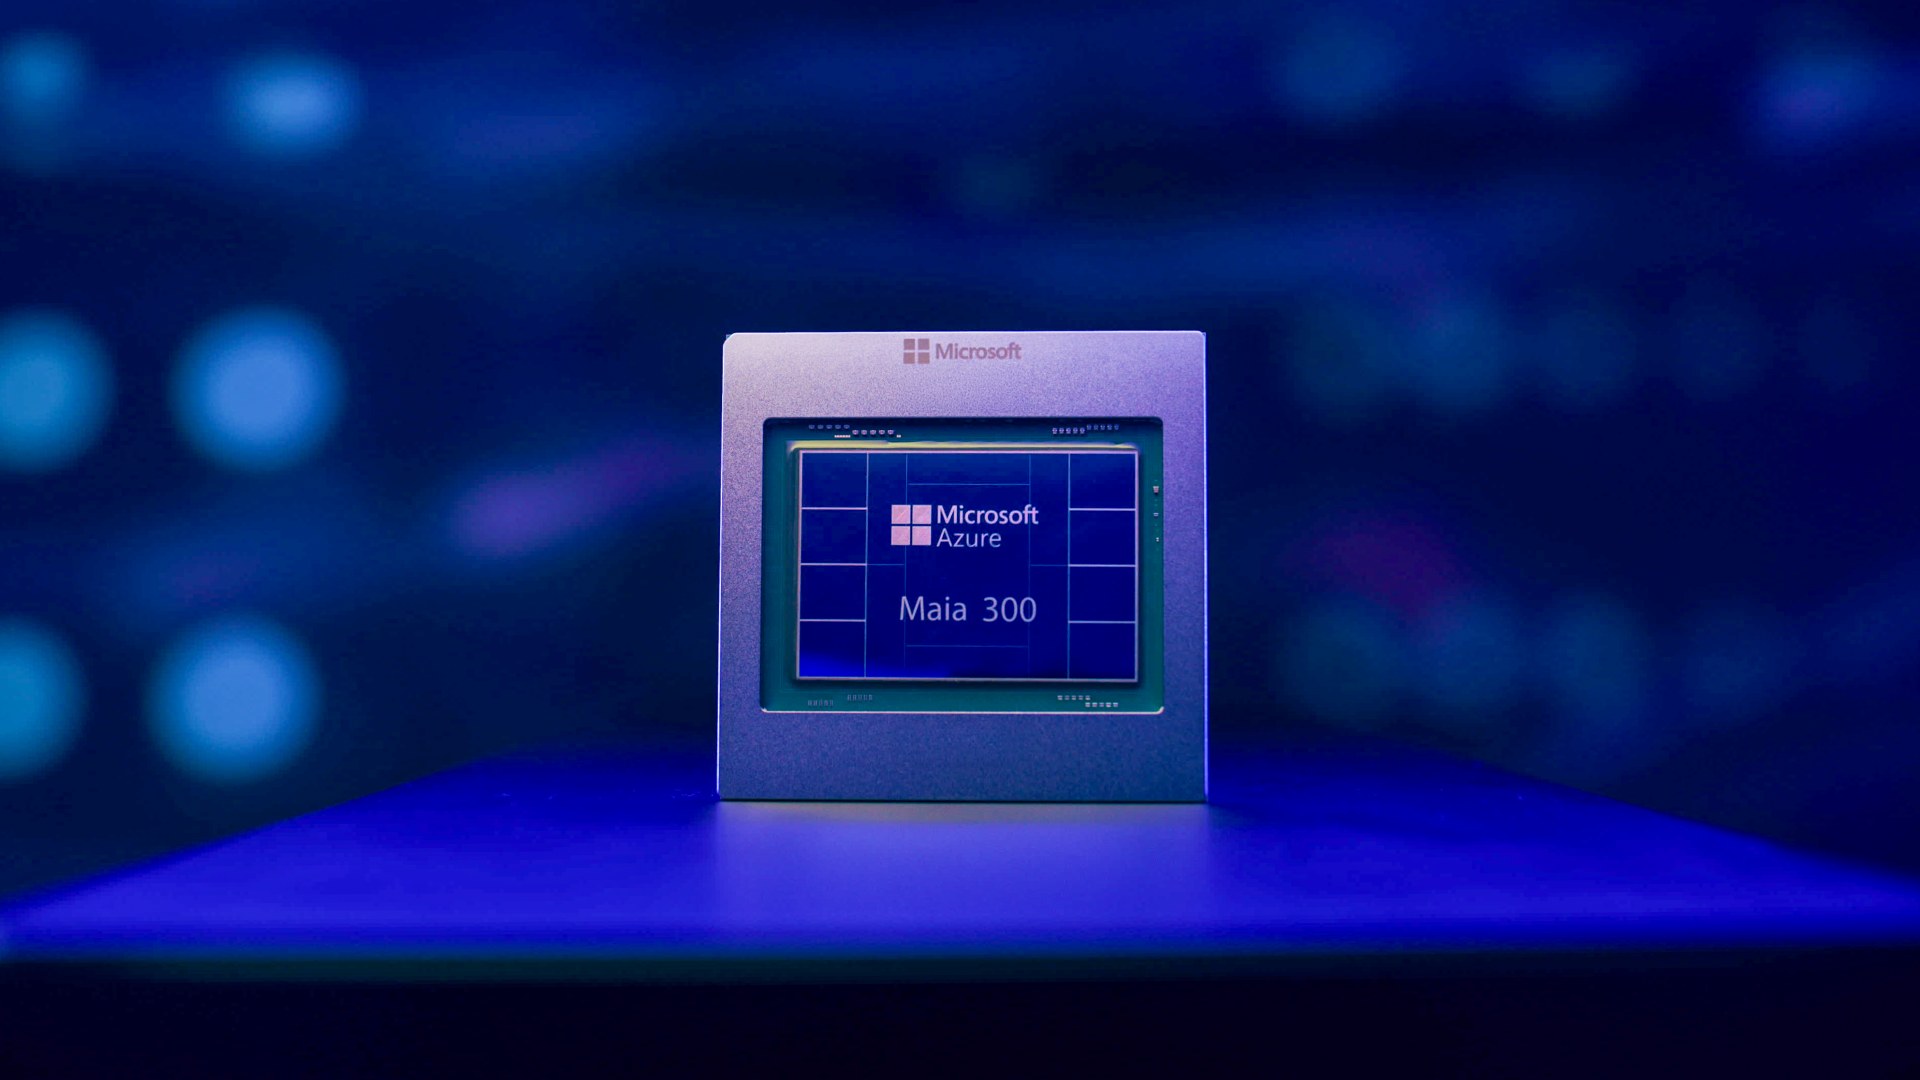
Maia 300, czyli liczby od producenta
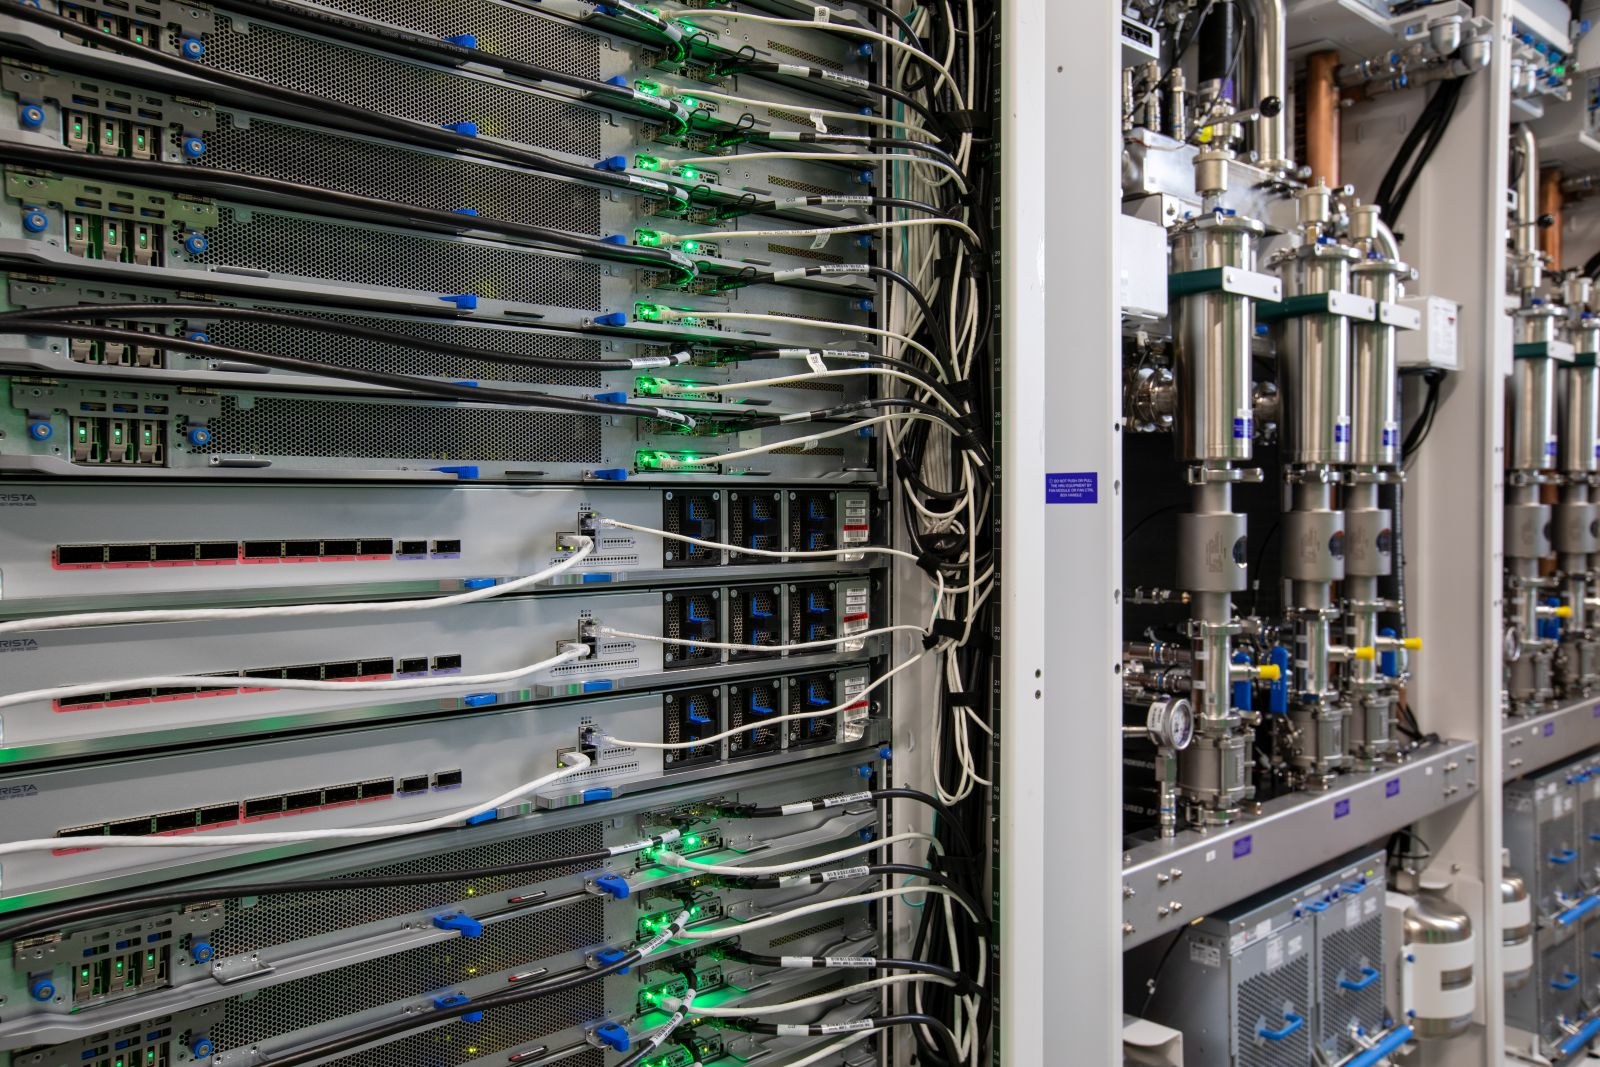
Najpierw to, co Microsoft deklaruje. Maia 300 powstaje w procesie N2P w fabrykach TSMC. Każdy akcelerator ma osiem stosów pamięci HBM4 o łącznej przepustowości do 18 TB/s i budżet mocy 950 watów. W pełnej szafie siedzi 96 takich układów, które razem pobierają około 167 kilowatów i mają do dyspozycji 27,6 TB pamięci HBM.
Najmocniejsze obietnice dotyczą efektywności:
- 40 procent więcej tokenów na megawat niż „wiodące systemy oparte na GPU",
- do 7 razy większa przepustowość tokenów na poziomie szafy niż w poprzedniej generacji, Maia 200.
Wdrożenia produkcyjne mają ruszyć w 2027 roku i od razu w skali wielu gigawatów. Reuters, powołując się na swoje źródła, podał, że Microsoft może w przyszłym roku uruchomić ponad milion takich chipów.
Trzeba to czytać z należytą ostrożnością. Wszystkie parametry pochodzą od samego Microsoftu, a jak zauważył UPI, w dniu premiery żadna zewnętrzna firma nie testowała jeszcze Maia 300. Wpis nie precyzuje też, z którymi konkretnie systemami GPU porównywano wynik 40 procent. To deklaracja, nie pomiar.
Poprzednik, Maia 200, już pracuje w centrach danych w Stanach Zjednoczonych, Europie i Australii. Napędza Copilota i funkcje AI w Teams, a do końca roku mają na niego trafić także GitHub Copilot i platforma Microsoft Foundry. Microsoft twierdzi, że Maia 200 daje 1,7 raza więcej tokenów na wat niż czołowa infrastruktura GPU. Matt Kimball z Moor Insights & Strategy skomentował w Data Center Knowledge, że pierwsza Maia była dowodem koncepcji, a przy 300 firma postanowiła „pójść na całość".
Nie trening, tylko odpowiedzi
Kluczowe słowo w tej historii to inferencja. Trening modelu to jednorazowy, gigantyczny wysiłek. Inferencja to codzienność: każde pytanie zadane czatowi, każde podsumowanie maila, każda podpowiedź kodu. To ona generuje rachunek za prąd, który rośnie z każdym nowym użytkownikiem.
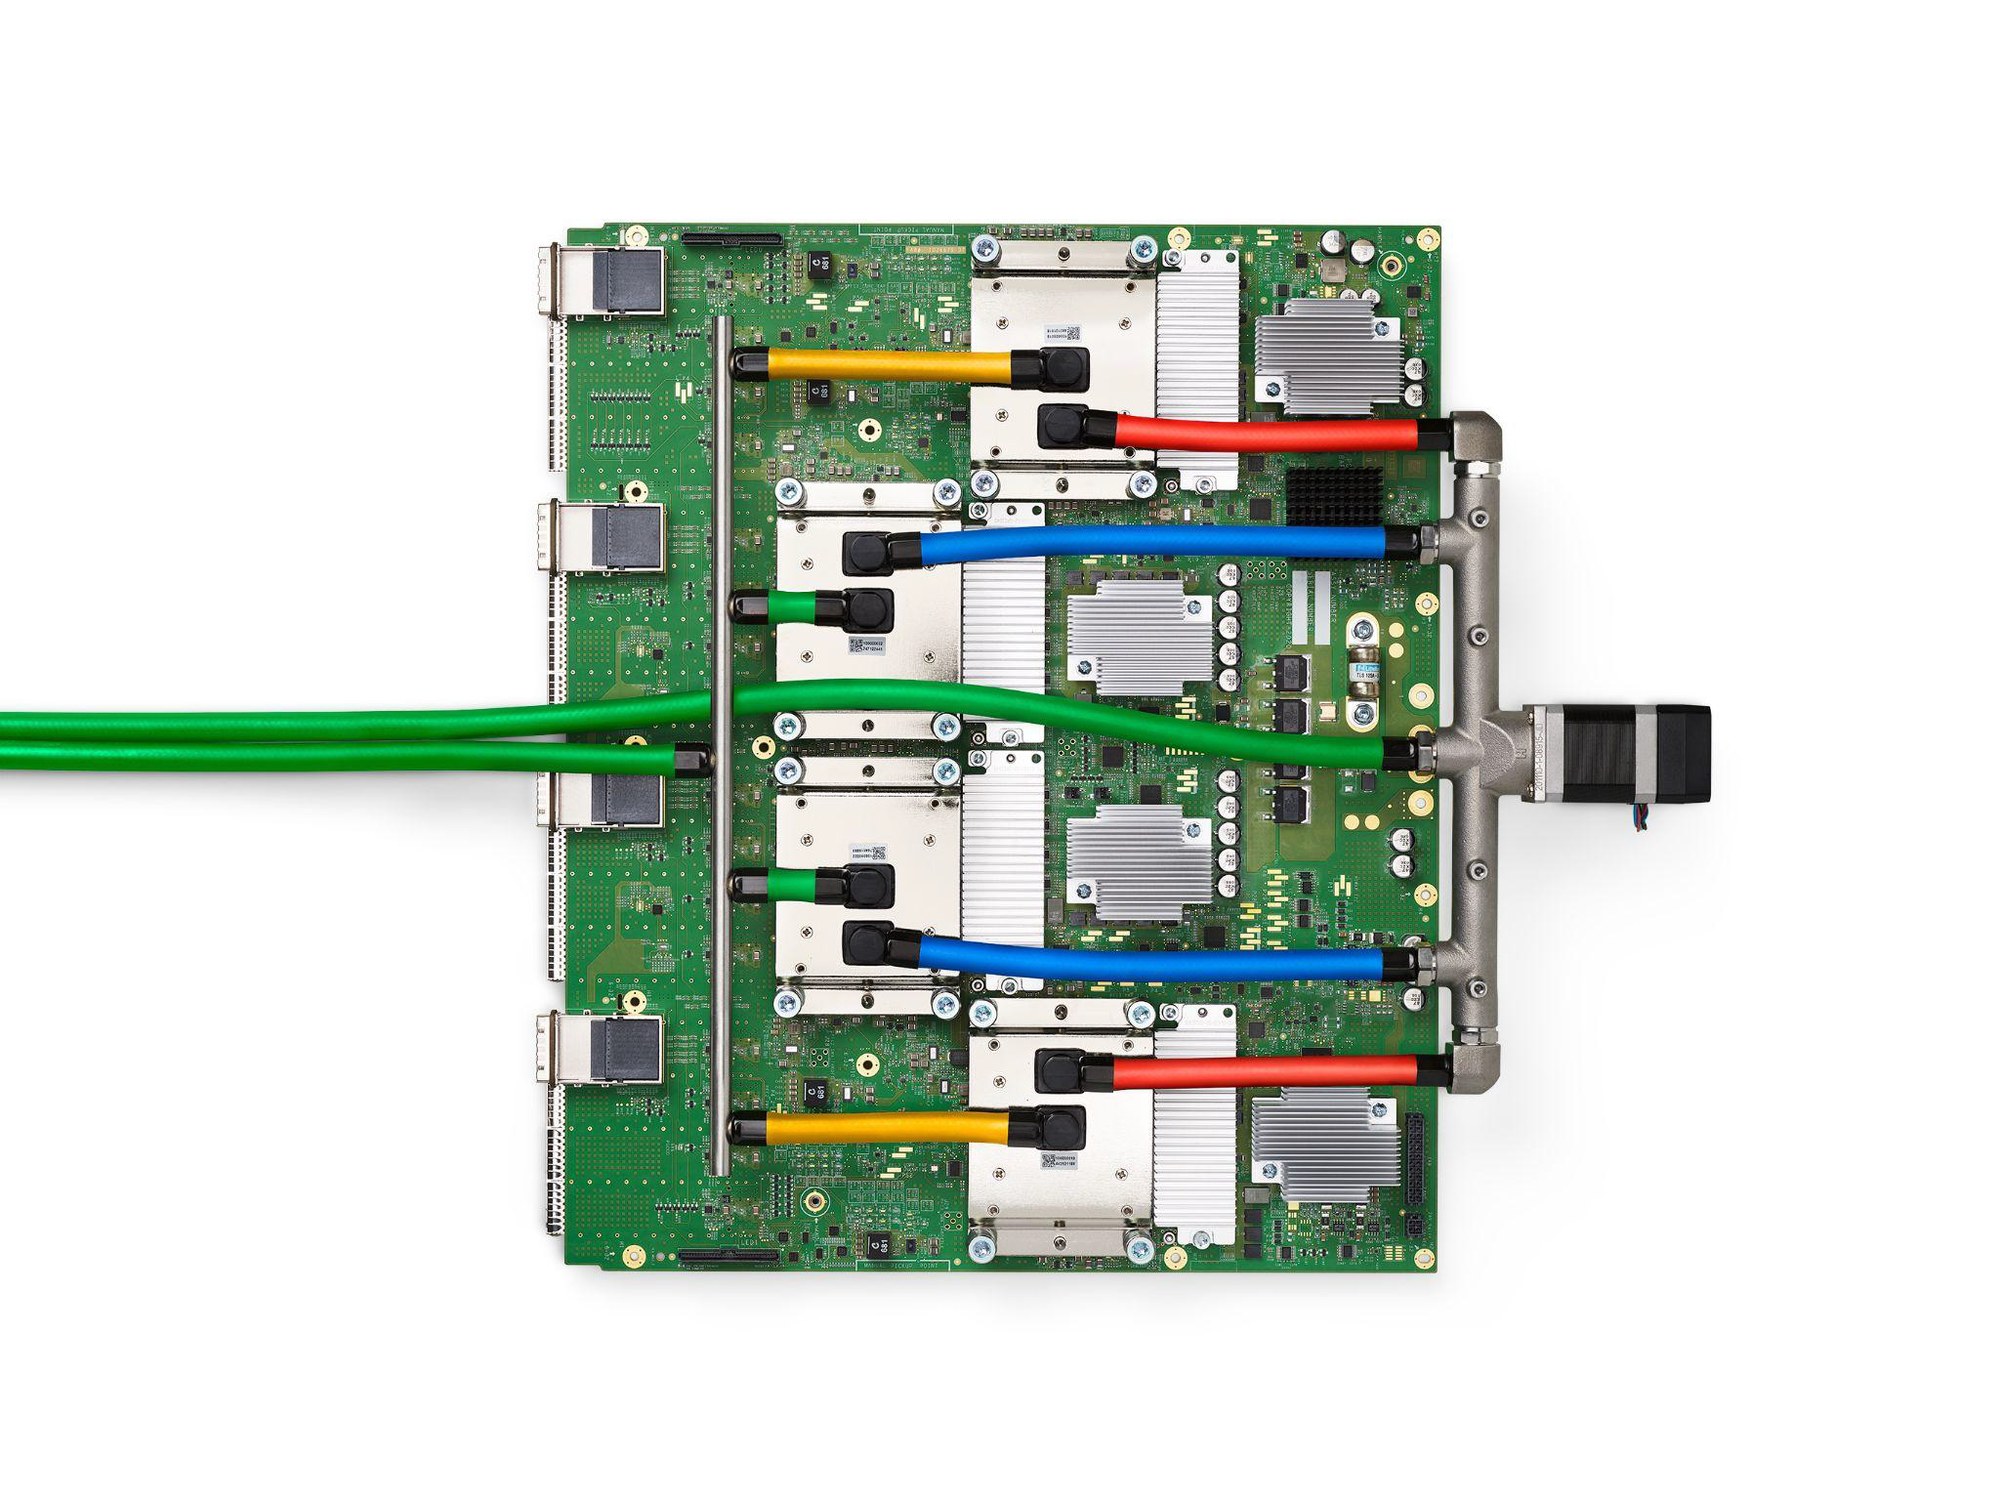
Dlatego niemal wszyscy giganci projektują własne układy przede wszystkim pod odpowiadanie, nie pod naukę. Google przedstawia siódmą generację swoich TPU, Ironwood, jako układ zbudowany do obsługi dużego ruchu przy niskich opóźnieniach. Ironwood jest dostępny dla klientów Google Cloud, a jeden superpod łączy do 9216 chipów i 1,77 PB wspólnej pamięci HBM. Google deklaruje ponad czterokrotnie lepszą wydajność na chip niż w poprzedniej generacji Trillium.
Meta w marcu ogłosiła cztery generacje układów MTIA naraz: 300, 400, 450 i 500, z nowym chipem mniej więcej co pół roku. Jak relacjonował StorageReview, firma ma już w produkcji „setki tysięcy" urządzeń MTIA, model 450 ma wejść do masowych wdrożeń na początku 2027 roku, a 500 w ciągu 2027. Chipy projektowane są z Broadcomem, wytwarzane przez TSMC i oparte na otwartej architekturze RISC-V.
Amazon idzie najdalej w stronę klienta zewnętrznego. Trainium3, pierwszy chip AWS w procesie 3 nm, trafił do ogólnej dostępności na przełomie listopada i grudnia 2025 roku podczas konferencji re:Invent. Serwer UltraServer mieści do 144 takich układów, a AWS deklaruje do 4,4 raza więcej mocy obliczeniowej niż w poprzedniej generacji i o 40 procent lepszą efektywność energetyczną. W przygotowaniu jest już Trainium4.
| Firma | Chip | Status |
|---|---|---|
| Microsoft | Maia 300 | ogłoszony 12.10.2026, wdrożenia od 2027 |
| Microsoft | Maia 200 | w produkcji, USA, Europa, Australia |
| TPU Ironwood (7. gen.) | dostępny w Google Cloud | |
| Amazon | Trainium3 | dostępny od re:Invent 2025, Trainium4 w drodze |
| Meta | MTIA 300 i 400 | w użyciu, MTIA 450 i 500 w 2027 |
Amazon kupuje nie chip, tylko klej
Do tej układanki doszedł w niedzielę 11 października element, który na pierwszy rzut oka do niej nie pasuje. The Wall Street Journal napisał, powołując się na osoby znające sprawę, że Amazon negocjuje przejęcie Decart, start-upu wycenianego w tych rozmowach na około 7 mld dolarów. To wciąż doniesienia, nie ogłoszenie: ani Amazon, ani Decart transakcji nie potwierdziły, a jak zaznaczają relacjonujące sprawę media, rozmowy mogą się jeszcze rozpaść.
Decart jest znany głównie z modeli generujących interaktywne światy i wideo w czasie rzeczywistym - Oasis i Lucy. Ale z perspektywy wyścigu o krzem ważniejsza jest jego druga warstwa: oprogramowanie, które pozwala uruchamiać i optymalizować modele AI na różnych procesorach. SiliconANGLE opisuje, że stos optymalizacyjny Decart skraca pracę nad dopasowaniem sieci neuronowej do konkretnego chipa z miesięcy do mniej więcej dwóch tygodni.
To dokładnie ten problem, z którym zderzają się wszystkie alternatywy dla Nvidii. Sam układ to połowa sukcesu. Druga połowa to oprogramowanie, które pozwala programistom przenieść model bez przepisywania wszystkiego od zera. Decart zna Trainium od środka: AWS dał mu wczesny dostęp do Trainium3, a w komunikacie Amazona firma chwaliła się czterokrotnie szybszą inferencją wideo przy połowie kosztu GPU.
Kilka szczegółów, przy których źródła się rozjeżdżają:
- SiliconANGLE podaje, że Decart zebrał łącznie ponad 400 mln dolarów, izraelski Calcalist pisze o około 450 mln,
- w maju firma była wyceniana na około 4 mld dolarów po rundzie 300 mln, w której uczestniczyła również Nvidia,
- według Bloomberga, cytowanego przez SiliconANGLE, wcześniej rozmowy o przejęciu za około 6 mld dolarów prowadził Anthropic, który wycofał się po badaniu due diligence; Calcalist mówi o przedziale 6-7 mld.
Jeśli transakcja dojdzie do skutku, Amazon kupi coś, czego nie da się wyprodukować w fabryce: skrót dla klientów, którzy chcieliby zejść z Nvidii, ale boją się kosztów przeprowadzki.
TSMC, czyli kasjer w tym wyścigu
Jest jeden zawodnik, który wygrywa bez względu na to, czyj chip okaże się lepszy. Maia 300 powstaje w TSMC, MTIA powstaje w TSMC, Trainium3 też. Tajwański producent zarabia zarówno na Nvidii, jak i na wszystkich, którzy próbują się od niej uniezależnić.
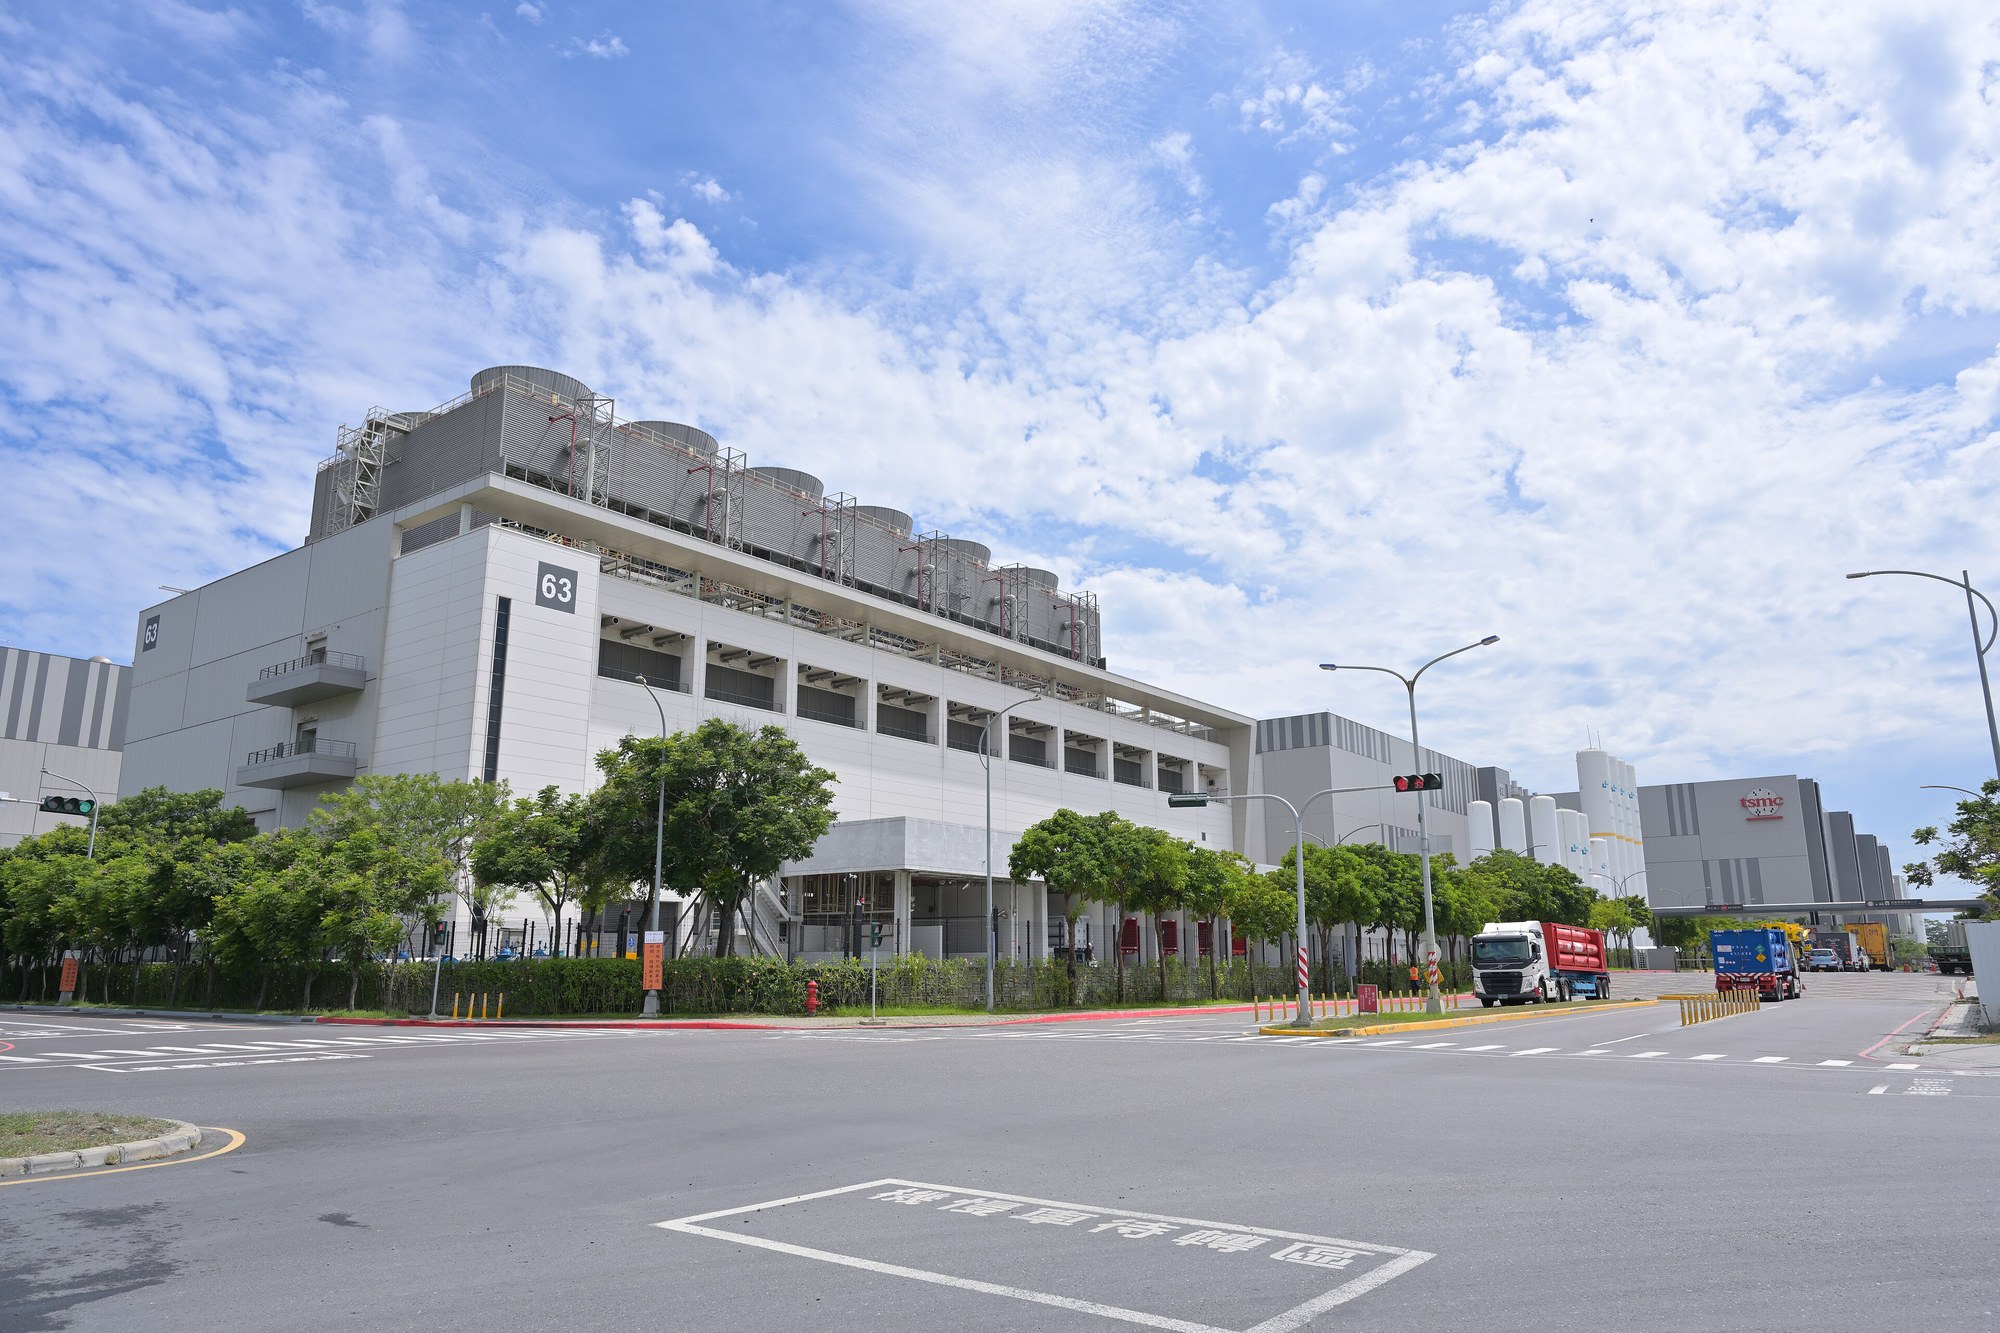
Liczby za trzeci kwartał są już częściowo znane. 8 października TSMC podał przychody za wrzesień: 511,86 mld dolarów tajwańskich, o 54,6 procent więcej niż rok wcześniej. Cały kwartał zamknął się rekordowym przychodem około 1,49 bln dolarów tajwańskich, powyżej górnej granicy prognozy firmy. Focus Taiwan przytacza opinie analityków, że za wynikiem stoi popyt na chipy AI oraz zapasy budowane przez producentów smartfonów przed premierami.
Zysk netto TSMC ma ogłosić w czwartek 15 października, konferencja wynikowa zaplanowana jest na 14:00 czasu tajwańskiego, czyli 8:00 w Polsce. Prognozy:
- według LSEG SmartEstimate z 16 wycen analityków zysk ma wzrosnąć o 65 procent, do 746,3 mld dolarów tajwańskich, czyli około 23,4 mld USD,
- inne zestawienia LSEG cytowane w mediach mówią o około 740,8 mld i wzroście o 64 procent,
- każdy wynik powyżej 706,56 mld będzie najwyższym zyskiem kwartalnym w historii firmy i szóstym rekordem z rzędu.
Analityk Morgan Stanley Charlie Chan spodziewa się, że TSMC podniesie prognozę wzrostu przychodów na cały rok z obecnych „ponad 40 procent" do przedziału od niskich do średnich 40 procent. Firma już w lipcu podniosła tegoroczne nakłady inwestycyjne do 60-64 mld dolarów.
A co z Nvidią?
Łatwo z tego wszystkiego wyczytać nekrolog Nvidii. To byłby błąd. W lutym ta sama Meta, która co pół roku chce wypuszczać nowe MTIA, podpisała z Nvidią wieloletnie partnerstwo obejmujące „miliony" GPU Blackwell i Rubin. Microsoft też nie mówi, że rezygnuje z kart innych producentów - Maia ma być podstawą inferencji we własnych usługach, nie jedynym krzemem w centrach danych. Do tego, jak zauważa Data Center Knowledge, Microsoft w ogóle nie udostępnia Maia klientom Azure, w przeciwieństwie do Amazona i Google.
Własne chipy nie wypychają więc Nvidii z rynku. Zmieniają za to układ sił przy stole negocjacyjnym. Kiedy klient ma realną alternatywę dla najbardziej masowej części pracy, czyli odpowiadania na pytania, łatwiej mu targować się o resztę. Nvidia przestaje być jedynym dostawcą, a staje się jednym z kilku.
Co z tego ma zwykły użytkownik
Nikt z gigantów nie napisał, że dzięki nowemu chipowi Copilot, Gemini czy modele w chmurze AWS stanieją. Szczerze mówiąc, takiej obietnicy nie znalazłem w żadnym z przejrzanych komunikatów. Ale logika jest prosta. Cena usługi AI to w dużej mierze koszt wygenerowania tokenu, a ten zależy od prądu i od marży dostawcy sprzętu. Każdy procent więcej tokenów na megawat to niższy koszt jednej odpowiedzi.
Najbliżej konkretu jest Amazon, który pisze, że klienci Trainium, w tym Anthropic, obniżają koszty treningu i inferencji nawet o 50 procent. To liczba marketingowa, ale pokazuje, gdzie leży stawka. Kto ma własny chip, ten sam decyduje, ile kosztuje mu jedna odpowiedź modelu.
Czy te oszczędności trafią do naszych portfeli, czy zostaną w marżach chmur - to już pytanie o konkurencję, nie o krzem. Pewne jest jedno: w czwartek TSMC pokaże, ile na tej gorączce zarabia ten, kto wszystkim wytwarza krzem. A rachunek za resztę wyścigu dostaniemy w kolejnych cennikach subskrypcji.
Tekst ukazał się w numerze 1 tygodnika Dygot (13 października 2026).
Źródła (19)
- Microsoft to expand Azure Maia system to multi-gigawatt deployments - Official Microsoft Blog, 12.10.2026
- Microsoft announces Maia 300, its next-generation custom AI chip - Microsoft Source EMEA, 12.10.2026
- Microsoft plans huge deployment of its own AI chips with an eye on saving costs - Reuters, 12.10.2026
- Microsoft unveils Maia 300 - The Verge, 12.10.2026
- Microsoft announces new AI chip Azure Maia 300 - UPI, 12.10.2026
- Microsoft Pushes Custom AI Chips with Azure Maia 300 - Data Center Knowledge, 10.2026
- Microsoft Unveils Maia 300 AI Chip, Plans Up to One Million Next Year - TIKR, 10.2026
- AI news October 13, 2026 - AIdapted, 13.10.2026
- Amazon in talks to buy AI startup Decart for around $7 billion, WSJ reports - Reuters, 11.10.2026
- Report: Amazon in talks with AI startup Decart over possible $7B acquisition - SiliconANGLE, 11.10.2026
- Amazon emerges as potential buyer of Israeli AI startup Decart at $7 billion - Calcalist, 10.2026
- TSMC expected to report sixth straight quarter of record profit thanks to AI boom - Reuters, 12.10.2026
- TSMC to get 6th straight record profit quarter - The Manila Times, 13.10.2026
- TSMC posts record quarterly revenue, highest-ever September sales - Focus Taiwan, 08.10.2026
- Financial Calendar - TSMC Investor Relations, dostęp 13.10.2026
- Trainium3 UltraServers now available - About Amazon, 12.2025
- 3 things to know about Ironwood, Google's latest TPU - Google Blog, 25.11.2025
- Meta's MTIA Roadmap: Four Chip Generations in Two Years Put GenAI Inference First - StorageReview, 13.03.2026
- Meta Builds AI Infrastructure With NVIDIA - NVIDIA Investor Relations, 17.02.2026