W czwartek 15 października Microsoft AI opublikował na swojej stronie długi tekst techniczny pod niepozornym tytułem „Frontier Pre-training at Microsoft AI”. Piętnaście minut czytania o optymalizatorach, routingu ekspertów i utylizacji procesorów graficznych. Tego samego dnia szef działu Mustafa Suleyman stanął przed pracownikami na wewnętrznym spotkaniu i powiedział rzecz, której w tekście nie było. Według relacji Business Insidera, powtarzanej potem przez kolejne serwisy, oznajmił, że Microsoft ma teraz mocniejszy model bazowy niż ten, który napędza GPT-5.6 Sol, i że do jego wytrenowania zużył jedną czwartą mocy obliczeniowej OpenAI.
To zdanie obiegło branżę szybciej niż jakikolwiek wykres z raportu. I dobrze pokazuje, o co naprawdę toczy się ta gra. Nie o kolejny model w katalogu, tylko o to, czy największy inwestor OpenAI potrafi się bez OpenAI obejść.
Co właściwie powstało
MAI-Base-2 to tak zwany model bazowy, czyli surowy efekt pretreningu. Jeszcze nie rozmawia, nie wykonuje poleceń, nie ma osobowości asystenta. To dopiero materiał, z którego w kolejnym etapie, potrenowaniu, robi się czatbota, model do kodu albo agenta. Microsoft pisze wprost, że model jest teraz na etapie potreningu. Daty premiery i cennika API nie podał.
Liczby z raportu Microsoft AI:
- 2,8 bln parametrów łącznie, z czego 80 mld aktywnych przy każdym tokenie,
- architektura mixture of experts w każdej warstwie: jeden ekspert wspólny plus 7 wybieranych z 512,
- 102 warstwy,
- 50 bln tokenów danych treningowych, wiedza do marca 2026,
- 4,5 bln unikalnych tokenów obrazu i tekstu, które po powtórzeniach dały 18 proc. mieszanki treningowej,
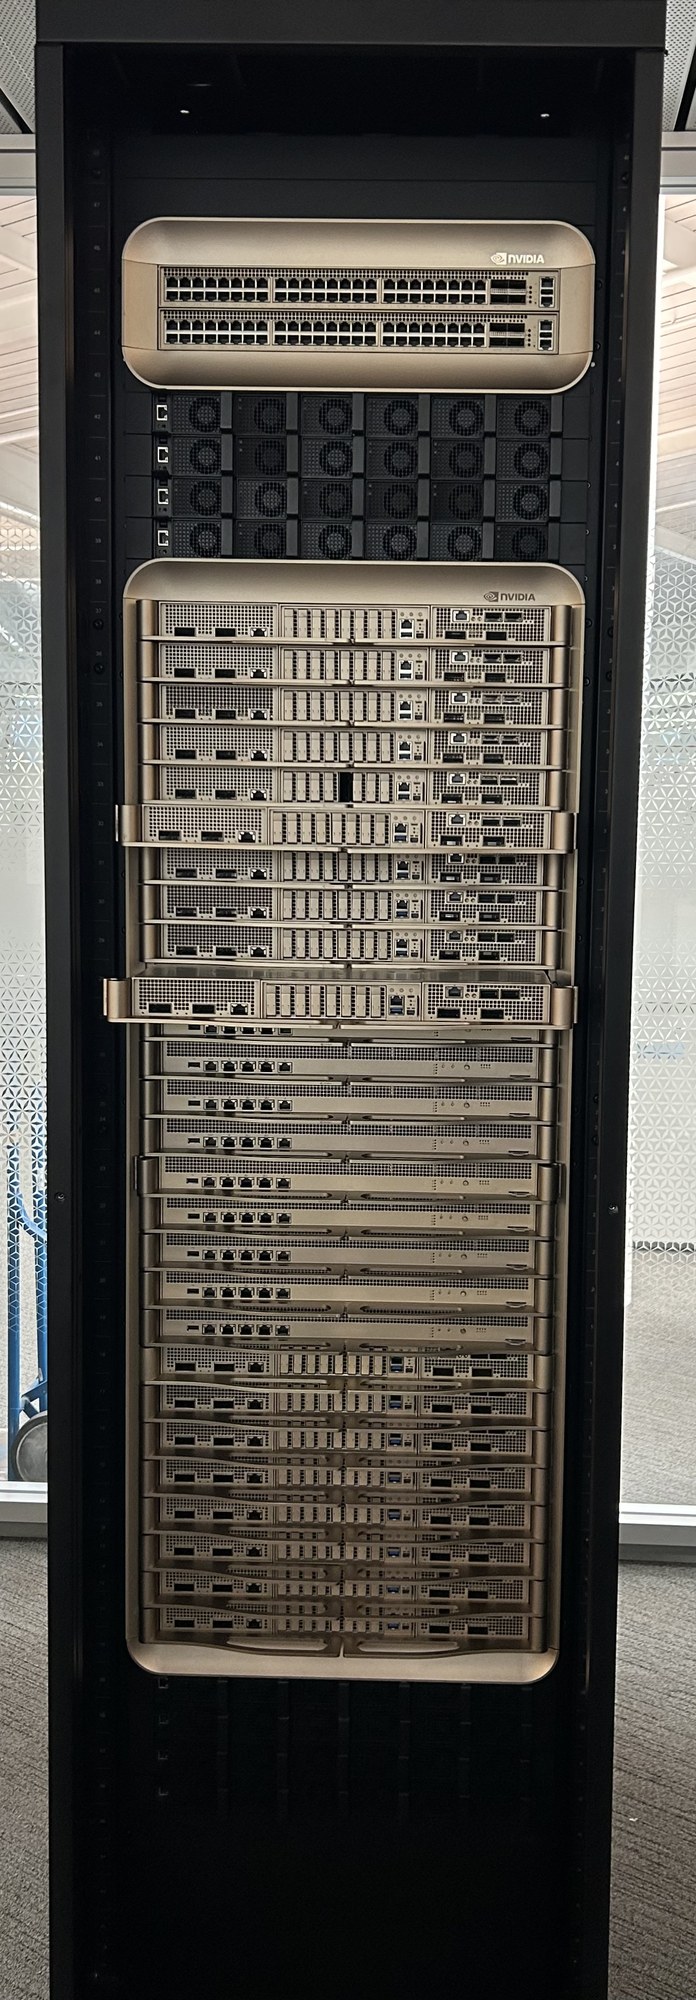
- trening na 16 tys. procesorów Nvidia GB200 przez 38 dni, w sierpniu i wrześniu 2026.
Dla porównania poprzednik, MAI-Base-1, miał bilion parametrów, w tym 35 mld aktywnych, 78 warstw i 30 bln tokenów. Nie widział obrazów w pretreningu. Nowy model uczy się wzroku od pierwszego dnia i to bez osobnego kodera obrazu, który w większości modeli jest doklejany z boku.
Z raportu wychodzi też sporo kuchni, którą laboratoria zwykle chowają. Średnia utylizacja mocy obliczeniowej (MFU) wyniosła 21 proc., a przez 89 proc. czasu trening faktycznie posuwał się do przodu, reszta to awarie, restarty i przestoje. Microsoft przesiadł się na optymalizator Muon i dorzucił własną technikę, którą nazywa przycinaniem gradientów aktywacji. Jak na firmę, która jeszcze rok temu kojarzyła się głównie z odsprzedawaniem cudzych modeli, to zaskakująco dużo szczegółów.
Szybciej niż DeepSeek, przynajmniej na papierze
Główna teza raportu brzmi: MAI-Base-2 bije każdy otwarty model, który Microsoft przetestował, a jego przepis treningowy jest od 4,2 do 12,3 raza wydajniejszy pod względem FLOP-ów niż DeepSeek-V4-Pro-Base, najmocniejszy otwarty model bazowy. Względem własnego MAI-Base-1 skok wynosi od 6,3 do 12,7 raza.
Warto jednak czytać drobny druk, bo Microsoft sam go napisał. Te mnożniki nie pochodzą z porównania dwóch prawdziwych przebiegów treningowych, tylko z praw skalowania, które firma dopasowała we własnym zakresie. Mierzono bity na bajt na wewnętrznych zbiorach kodu oraz zamówionych przez Microsoft zestawach z nauk ścisłych, matematyki i pytań z odpowiedziami. Trzy z porównywanych modeli, w tym Kimi K3 i Qwen, były dostępne tylko w wersjach po potreningu, co Microsoft sam zaznacza jako możliwe zakłócenie wyniku.
Analitycy Constellation Research zwrócili uwagę na jeszcze jeden paradoks. Microsoft porównuje się wyłącznie z modelami otwartymi, przez co MAI-Base-2 wygląda jak kandydat do tej ligi. Tyle że wag nikt nie dostanie do pobrania. Firma zapowiada licencjonowanie ich „zaufanym partnerom” przez platformę Foundry. Constellation nazywa to nową kategorią modeli „półotwartych”: wystarczająco dobrych, nie z absolutnej czołówki i nie do końca wolnych, sprzedawanych w pakiecie z umową korporacyjną.
Zdanie, którego nie ma w raporcie
Wróćmy do Suleymana. Według Business Insidera na czwartkowym spotkaniu powiedział pracownikom, że Microsoft prywatnie porównał MAI-Base-2 z modelem OpenAI, na którym stoi GPT-5.6 Sol, i że wygrał, zużywając jedną czwartą mocy obliczeniowej. Mówił też o dwunastokrotnej przewadze nad DeepSeekiem.
Serwis TensorFeed przejrzał opublikowany raport i zauważył, że słowo „OpenAI” nie pada w nim ani razu. Porównania z modelami OpenAI, Google czy Anthropic po prostu nie ma. Z kolei dwunastka to górna granica przedziału 4,2-12,3, a nie typowy wynik. Serwis 24/7 Wall St. przypomniał rzecz oczywistą, ale ważną: Suleyman kieruje działem, którego pracę ocenia. OpenAI publicznie ani tego nie potwierdziło, ani nie zaprzeczyło. Microsoft odmówił komentarza.
Microsoft przez lata kupował mózg od OpenAI. Teraz pokazuje, że potrafi go wyhodować sam, i to taniej.
Nie znaczy to, że Suleyman się myli. Znaczy tyle, że na dziś jedynym dowodem jest jego słowo, wypowiedziane do własnych ludzi na spotkaniu, które miało ich zmotywować.
Po co Microsoftowi własny mózg
Microsoft ma w OpenAI udziały, które 24/7 Wall St. wycenia na 135 mld dolarów, pozostaje jego głównym partnerem chmurowym i ma prawa do technologii OpenAI do 2032 roku. Po co więc wydawać miliardy na równoległy wyścig?
Odpowiedź jest w samym raporcie i w czerwcowej zapowiedzi MAI-Thinking-1. Microsoft powtarza trzy słowa: kontrola, pochodzenie danych, samowystarczalność. Firma podkreśla, że jej pretrening opiera się na „organicznych danych”, bez destylacji z cudzych modeli. To przytyk do konkurencji i zarazem argument sprzedażowy. Klient korporacyjny, który boi się procesów o prawa autorskie, chce wiedzieć, na czym model się uczył. Microsoft twierdzi, że ma nad tym pełną kontrolę, bo cały łańcuch, od danych po wagi, należy do niego.
Jest też powód bardziej przyziemny. Każde zapytanie do Copilota obsługiwane modelem OpenAI to koszt i zależność od partnera, który coraz wyraźniej idzie własną drogą. Własny model to własna marża. Microsoft buduje tę niezależność krok po kroku:
- MAI-Base-1, bilion parametrów, był pierwszym poważnym modelem bazowym działu,
- MAI-Thinking-1, model rozumujący zbudowany na MAI-Base-1, został pokazany na konferencji Build 2 czerwca, a od 12 sierpnia jest w publicznym podglądzie w Foundry,
- MAI-Base-2 jest teraz w potreningu,
- według Microsoftu przygotowania do MAI-Base-3 już trwają.
Przy MAI-Thinking-1 Microsoft deklarował, że w ślepych testach ludzie woleli go od Claude Sonnet 4.6, a na SWE-Bench Pro idzie łeb w łeb z Claude Opus 4.6. To deklaracje producenta, nie niezależne pomiary, ale pokazują ambicję: nie gonić już wczorajszej czołówki, tylko stanąć obok niej.
Co dalej
Na razie MAI-Base-2 to obietnica. Nie da się go wypróbować, nie ma niezależnych testów, nie wiadomo, jak wypadnie po potreningu, czyli w postaci, z którą ktokolwiek naprawdę będzie pracował. Model bazowy z dobrymi bitami na bajt to jeszcze nie dobry asystent, o czym przekonało się już kilka laboratoriów.
Raport ma jednak jedną niezaprzeczalną zaletę: jest rzadkim przypadkiem, gdy zamknięte laboratorium pokazuje tyle szczegółów treningu. Liczby można sprawdzić, porównać, podważyć. Czego nie można powiedzieć o zdaniu wypowiedzianym na spotkaniu z pracownikami.
Prawdziwy test przyjdzie, gdy MAI-Base-2 trafi do Foundry i do Copilota. Wtedy okaże się, czy Microsoft zbudował sobie mózg, czy tylko bardzo drogi argument w negocjacjach z OpenAI. Na razie wygląda na to, że jedno i drugie.
Źródła (8)
- Frontier Pre-training at Microsoft AI - Microsoft AI, 15.10.2026
- Introducing MAI-Thinking-1 - Microsoft AI, 2026
- Microsoft's MAI-Base-2 is here: Suleyman says it beats OpenAI's GPT-5.6 model with a quarter of the compute - Windows Mode, 10.2026
- Suleyman Told Staff MAI-Base-2 Beats the Model Behind GPT-5.6 Sol on a Quarter of the Compute. Microsoft's Own Paper Only Compares Open Models - TensorFeed, 10.2026
- Microsoft's AI Chief Says It Built a Better Model Than OpenAI's With a Quarter of the Computing Power - 24/7 Wall St. / Yahoo Finance, 16.10.2026
- Microsoft's releases MAI-Base-2 aimed at open models with a twist - Constellation Research, 10.2026
- Microsoft Unveils 2.8 Trillion-Parameter AI Model, Claims Major Efficiency Gains - TechRepublic, 10.2026
- Microsoft Completes MAI-Base-2 Pre-Training - Technology.org, 16.10.2026