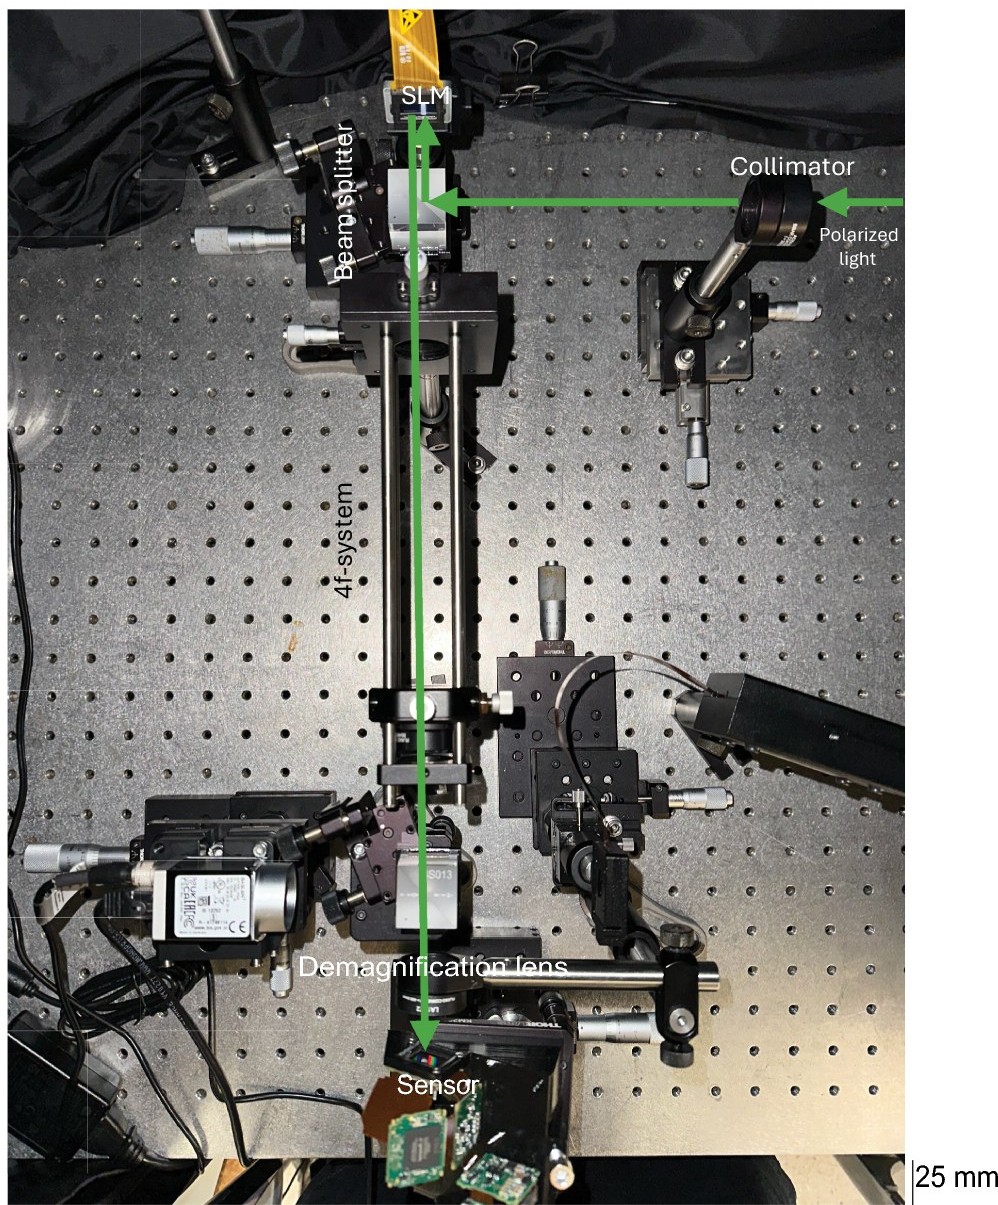
Pierwszego października serwis ScienceDaily opublikował komunikat o eksperymencie, który brzmi jak scenariusz science fiction. Na stole optycznym na UCLA światło przechodzi przez programowalny ekran ciekłokrystaliczny, rozchodzi się w niewielkiej przestrzeni i trafia na detektory. W tym jednym przejściu, w ułamku chwili, układ ocenia 15 filmów naraz: które są prawdziwe, a które podrobione. W teście na znanym zbiorze deepfake'ów Celeb-DF trafił w 97,79 procent przypadków.
Tydzień później, 7 października, czasopismo Science Advances wydrukowało pracę z Uniwersytetu Chicagowskiego o zupełnie innym problemie, ale z tym samym motywem. Pytanie brzmiało: czy sztuczna inteligencja rozpozna zagrożenie, którego nigdy wcześniej nie widziała? W Chicago chodziło o ulewę, w Los Angeles o fałszywe wideo.
Laser zamiast karty graficznej
Zespół Aydogana Ozcana z wydziału elektrotechniki UCLA i California NanoSystems Institute od lat buduje tak zwane dyfrakcyjne procesory optyczne. Najprościej mówiąc, to urządzenia, w których część obliczeń sieci neuronowej robi samo światło, uginając się na odpowiednio ukształtowanych warstwach. Nowa praca, której pierwszymi autorami są Parnian Ghapandar Kashani i Shiqi Chen, ukazała się w czasopiśmie eLight pod tytułem „Scalable, Energy-Efficient Optical-Neural Architecture for Multiplexed Deepfake Video Detection". Wersja robocza leży w serwisie arXiv od 19 maja.
Układ jest hybrydowy i działa w kilku krokach:
- mały cyfrowy koder wyciąga z każdego filmu cechy przestrzenne, częstotliwościowe i czasowe (w obliczeniach energii autorzy liczą po 12 klatek na wideo),
- cechy 15 lub więcej filmów zamieniane są na jeden wzór fazowy wyświetlany na przestrzennym modulatorze światła (SLM),
- światło widzialne przechodzi przez modulator i swobodnie propaguje w pasywnym dekoderze optycznym,
- pary detektorów dla każdego kanału dają wynik: prawdziwe albo fałszywe.
Kluczowe jest to, że najdroższą część obliczeń, czyli dekodowanie, robi fizyka. Autorzy przypominają, że czołowe cyfrowe detektory deepfake'ów potrzebują setek miliardów operacji zmiennoprzecinkowych na jedną analizę i przetwarzają filmy po kolei. Tu wydajność rośnie razem z rozmiarem apertury optycznej, a nie z liczbą procesorów.
Dlaczego czułość ważniejsza niż trafność
Najciekawsza liczba w tej pracy nie dotyczy trafności. Układ wyłapuje 99,86 procent fałszywek, więc przepuszcza tylko około 0,14 procent podróbek. Za to swoistość, czyli zdolność do uznania prawdziwego filmu za prawdziwy, wynosi 95,72 procent. Nieco ponad 4 procent autentycznych materiałów zostaje więc oznaczonych jako podejrzane.
Dla Ozcana to nie wada, tylko założenie projektu. W preprincie autorzy wprost piszą, że ich detektor ma być pierwszym, bardzo czułym sitem w większym systemie. Wszystko, co zaświeci na czerwono, i tak ma trafić do dokładniejszego, droższego modelu cyfrowego. Lepiej sprawdzić drugi raz sto prawdziwych filmów, niż przepuścić jedną dobrze zrobioną fałszywkę.
Porównanie energetyczne z preprintu jest konkretne. Przy tym samym cyfrowym koderze dekoder optyczny zużywał 1,38-4,11 milidżula na film. Głęboki dekoder cyfrowy osiągał podobną trafność (98,24 procent) przy około 37,36 mJ. Prosty klasyfikator drzewiasty był niemal darmowy energetycznie, ale trafiał tylko w 62,62 procent przypadków.
Po rozszerzeniu układu do 18 filmów naraz trafność spadła do 96,13 procent. Autorzy tłumaczą to przenikaniem się sygnałów sąsiednich kanałów. Najsłabiej wypadały kanały przy brzegach pola widzenia, gdzie optyka zniekształca obraz najbardziej.
Veo 3 i odporność na włamania
Celeb-DF to klasyczne podmiany twarzy, które zostawiają ślady w obrazie. Dlatego zespół zrobił własny zbiór fałszywek z modelu Google Veo 3, generowanych przez publiczny interfejs Gemini. Wystarczyło lekkie dostrojenie na 50 takich filmach, poniżej 1 procent pierwotnego treningu. W eksperymencie trafność wyniosła 94,80 procent, a czułość 97,61 procent. Testowano 105 prawdziwych i 105 sztucznych nagrań, których model wcześniej nie widział.
Trudniejszy okazał się zbiór DeepSpeak, w którym twarze podmieniano między osobami podobnymi z wyglądu i głosu. Sam dekoder optyczny bez dodatkowych warstw osiągnął tam około 77 procent. Po dodaniu dwóch pasywnych warstw dyfrakcyjnych wynik rośnie, a takie warstwy można wytrawić litograficznie i nie potrzebują prądu. Tu źródła podają różne liczby. Komunikat prasowy mówi o poprawie o około 6,8 procent, a majowy preprint o wzroście do około 88 procent. Rozbieżność może wynikać z różnic między wersją roboczą a opublikowaną.
Jest jeszcze argument bezpieczeństwa. Cyfrowy detektor, którego wagi wyciekną, można oszukać specjalnie dobranym szumem. Parametry układu optycznego są zapisane w fizycznym kształcie warstw. Według autorów zmierzenie ich z dokładnością na granicy dyfrakcji światła to poważne wyzwanie metrologiczne. W testach układ zniósł też szum, rozmycie, kompresję JPEG, przesunięcia elementów optyki i ataki typu black-box.
Fałszywe nagranie przepuszczone przez detektor nie trafia do procesora graficznego, tylko do wiązki światła.
Ograniczenia warto mieć przed oczami:
- to stanowisko laboratoryjne, nie produkt, a moduły w serwerowniach platform wideo to wciąż kwestia przyszłości,
- cyfrowy koder dalej zjada energię, a autorzy pokazują, że po jego odchudzeniu do poniżej 40 mJ na film czułość zostaje na poziomie 97,45 procent, za to spada swoistość,
- przy nowych generatorach wideo układ trzeba dostrajać, co pokazał test na Veo 3,
- najlepsze wyniki dotyczą zbioru, w którym fałszywki wciąż mają artefakty podmiany twarzy.
Ulewa, której model nie widział
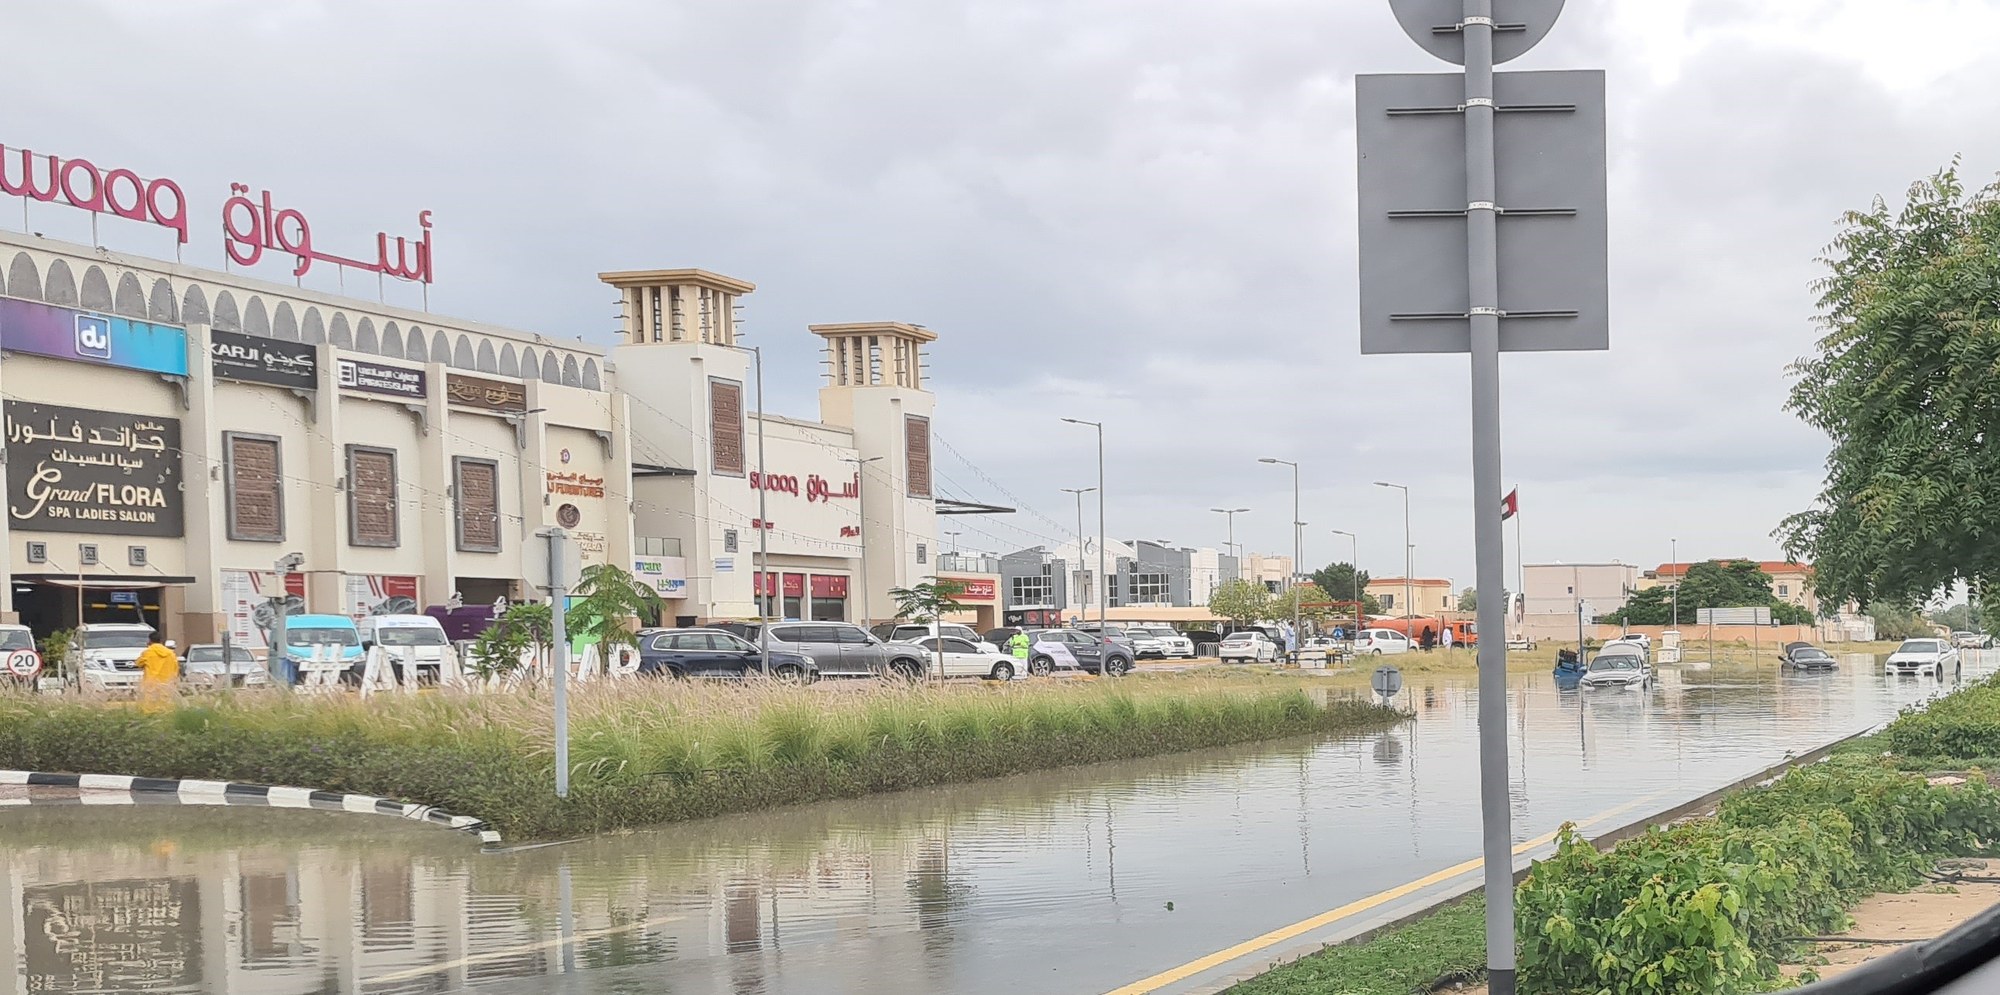
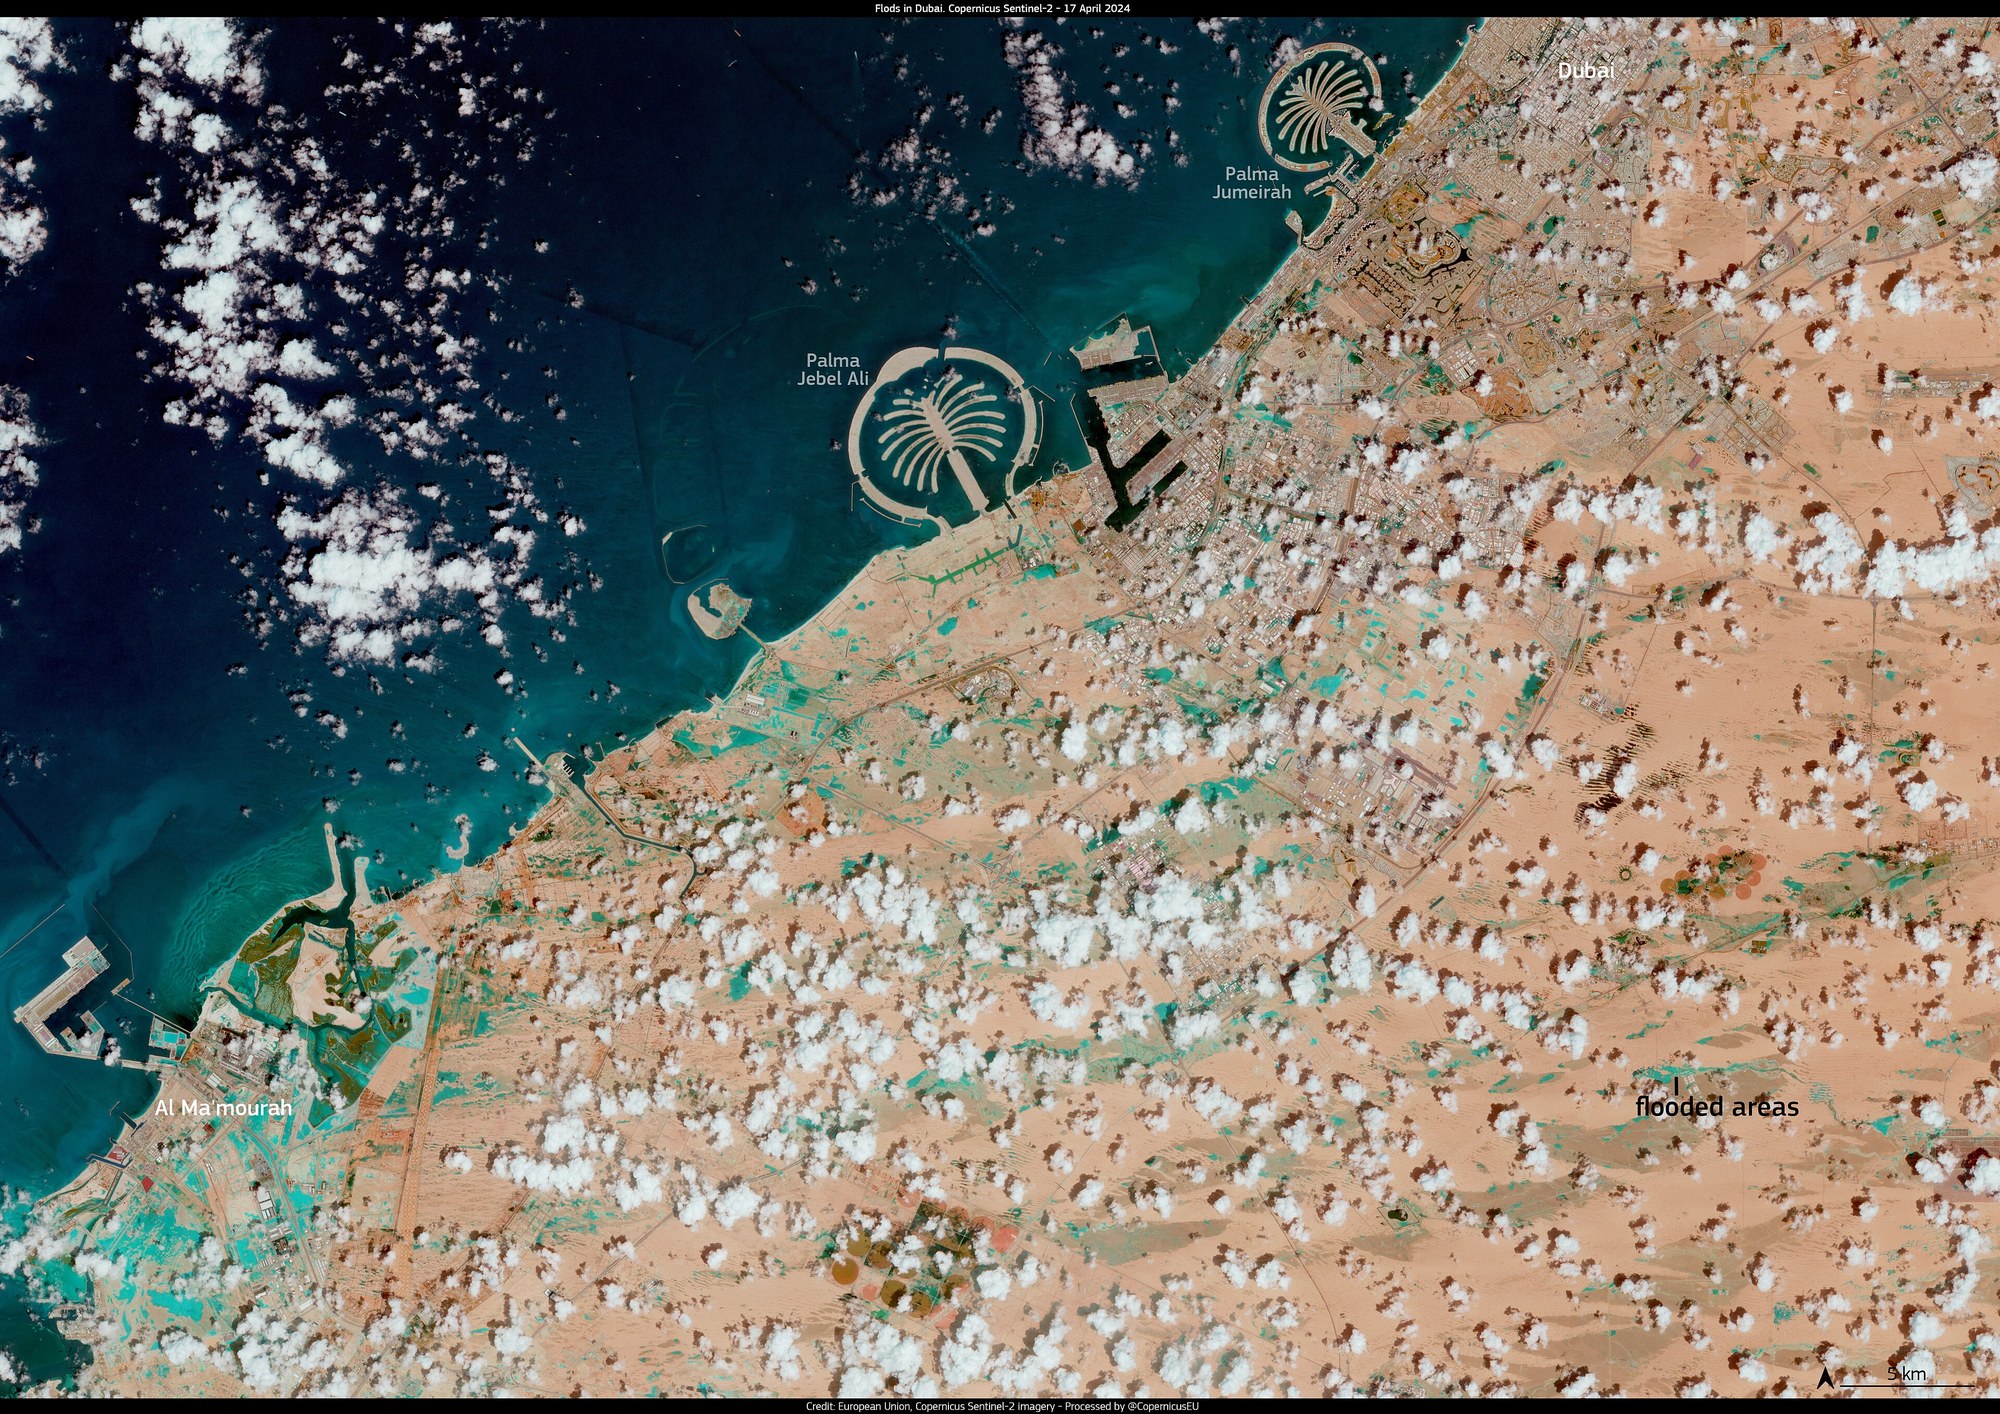
W Chicago punktem wyjścia była prawdziwa katastrofa. W kwietniu 2024 roku na Dubaj spadła ulewa, która według komunikatu uczelni zabiła pięć osób i spowodowała szkody ubezpieczeniowe szacowane na 3 miliardy dolarów. Szczytowy opad był dwa razy wyższy niż najwyższy opad w tym regionie zapisany w danych, na których trenowano modele AI.
Klimatolodzy nazywają takie zjawiska szarymi łabędziami. To zdarzenia fizycznie możliwe, ale tak rzadkie, że nie ma ich w historycznych pomiarach. Y. Qiang Sun (dziś na Uniwersytecie w Nankinie), Pedram Hassanzadeh, Tiffany Shaw, Hamid A. Pahlavan i Adam Marchakitus sprawdzili, jak radzą sobie z nimi trzy modele: GraphCast od Google DeepMind, AIFS z Europejskiego Centrum Prognoz Średnioterminowych i chiński FuXi.
Według komunikatu uczelni wszystkie trzy przewidziały miejsce i czas ulewy z pięciodniowym wyprzedzeniem. Dwa dobrze oszacowały też jej siłę, a trzeci wyraźnie ją zaniżył. Preprint na arXiv idzie dalej i podaje, że GraphCast i AIFS trafnie prognozowały zdarzenie nawet osiem dni wcześniej, a FuXi zaniżał opady.
Ciekawsze jest pytanie, skąd model wiedział, że będzie tak źle. Badacze sprawdzili dwie hipotezy. Ekstrapolacja oznaczałaby, że model wyciąga wnioski ze słabszych lokalnych ulew. Translokacja oznaczałaby, że uczy się z podobnych, silniejszych burz w innych częściach świata. Żeby to rozstrzygnąć, obcięli wartości opadów w danych treningowych wszędzie poza Dubajem. Gdyby działała ekstrapolacja, prognoza nie powinna się pogorszyć. Pogorszyła się. Dowodów na ekstrapolację nie znaleziono, model po prostu „pożyczał" doświadczenie z innych regionów.
Gdzie AI wciąż przegrywa z fizyką
To nie jest historia o wszechmocnej sztucznej inteligencji, bo autorzy sami studzą entuzjazm:
- wszystkie trzy modele mocno zaniżały najsilniejsze ulewy w skali globalnej, czyli tam, gdzie nie ma od kogo „pożyczyć" doświadczenia,
- problemem nie jest tylko mała liczba ekstremów w danych, ale też tzw. błąd spektralny - sieci łatwo uczą się dużych struktur pogodowych, a gorzej drobnych szczegółów, od których zależy siła opadu,
- według uczelni obecne możliwości nie wystarczają jeszcze do ostrzeżeń z odpowiednio dużym wyprzedzeniem.
Inna tegoroczna praca w Science Advances, autorstwa Zhanga, Fischera, Zscheischlera i Engelkego, ma już w tytule tezę, że modele fizyczne przewyższają prognozy AI przy ekstremach bijących rekordy.
Obok tego wyniku warto postawić pracę z MIT, która w październiku często wraca w podsumowaniach jako „nowa". Naprawdę ukazała się w Nature Communications 20 sierpnia. Kai Chang i Themis Sapsis zbudowali metodę η-learning, która nie prognozuje pogody na jutro. Generuje za to wiarygodne scenariusze ekstremów, których nie ma w danych. Wzięli 25 lat godzinowych map opadów, a model uczyli na parach map z zaledwie pierwszych sześciu miesięcy. Przykład z komunikatu MIT: rekord opadu w Nowym Jorku to 200 mm, więc jak wyglądałaby burza, która da 300 mm? Takie odpowiedzi przydają się ubezpieczycielom, urbanistom i operatorom sieci energetycznych. Warunek jest taki, że dla każdego nowego zagrożenia potrzebne są dane punktowe i mapy przestrzenne właśnie dla niego.
Wspólny mianownik
Oba październikowe wyniki mówią o tym samym, tylko w innych językach. Sztuczna inteligencja najlepiej radzi sobie z tym, co nowe, gdy może to odnieść do czegoś podobnego. W Chicago chodziło o burze z innych szerokości geograficznych, w Los Angeles o kilkadziesiąt próbek z nowego generatora wideo. Gdy takiego punktu odniesienia brakuje, maleje i trafność ulewy, i pewność detektora.
Dlatego z obu prac wyłania się AI jako pierwsza linia obrony, a nie wyrocznia. Optyczny detektor ma przesiewać, a człowiek albo cięższy model ma rozstrzygać. Model pogody ma dać kilka dni ostrzeżenia, a decyzję o ewakuacji i tak podejmą ludzie. To mniej efektowne niż hasło „AI wykrywa wszystko", ale za to uczciwe.
Tekst ukazał się w numerze 1 tygodnika Dygot (13 października 2026).
Źródła (8)
- This light-powered AI can spot deepfakes with nearly 98% accuracy - ScienceDaily, 01.10.2026
- Scalable, Energy-Efficient Optical-Neural Architecture for Multiplexed Deepfake Video Detection - arXiv, 19.05.2026
- Light-powered AI detects deepfakes at scale with 98% accuracy - Digital Journal, 04.10.2026
- AI Weather Models Can Predict Unprecedented Extreme Events by Learning from Other Regions - University of Chicago, 07.10.2026
- Predicting regional gray swans via translocation: AI weather models and Dubai's unprecedented 2024 rainfall - Science Advances, 07.10.2026
- Predicting Beyond Training Data via Extrapolation versus Translocation (preprint) - arXiv, 15.05.2025, wersja 3 z 02.02.2026
- Physics-based models outperform AI weather forecasts of record-breaking extremes - Science Advances, 2026
- Generating scenarios for extreme events, without extreme data - MIT News, 24.08.2026